Fable 5.1
20
23.0 КБ118.9 с10096 токенов · из них 200 на размышления
Семь моделей от семи команд получают одно и то же задание и работают сами.
На страницу идёт первый ответ, оценки ставят сами участники вслепую.
Как именно
Работы публикуются целиком — их можно открыть и потрогать. Каждый судья видит только чужие
работы и раздаёт им баллы, за себя голосовать нельзя. Это не лабораторный бенчмарк, а живое
сравнение на обычных просьбах, с которыми к нейросети приходит человек.
У GPT-6 Astra работы переделаны свежей моделью 6 сентября 2026, а оценки под ними остались от прошлого прогона: переголосование будет отдельно. Смотрите на работы, а не на её баллы, пока эта строка здесь.
Сумма баллов по всем заданиям. За одно задание можно набрать максимум 30 — если каждый соперник поставил высшую оценку.
| Модель | Баллы | Побед | Отдача | Токенов, тыс. | Время | Стоимость | |
|---|---|---|---|---|---|---|---|
| 1 | Fable 5.1 | 145 | 2 | 58.3 | 115.6 | 20 мин | 7.45 $ |
| 2 | Kimi K3 | 133 | 3 | 61.6 | 476.8 | 138 мин | 7.64 $ |
| 3 | GPT-6 Astra | 118 | 1 | 49.1 | 43.3 | 17 мин | 3.83 $ |
| 4 | Gemini 3.8 Flash | 113 | 1 | 77.1 | 108.3 | 441 с | 0.52 $ |
| 5 | Qwen 3.8 Max | 100 | 1 | 57.5 | 476.2 | 122 мин | 3.15 $ |
| 6 | Grok 4.6 | 96 | 0 | 49.9 | 215.0 | 31 мин | 1.63 $ |
| 7 | DeepSeek V4 Pro | 60 | 0 | 40.7 | 467.8 | 39 мин | 0.94 $ |
таблицу можно листать вбок →
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Gemini 3.8 Flash | 47.9 | 11.9 | 0.08 $ | 68 с | 13 | 100.0 |
| Qwen 3.8 Max | 41.2 | 23.9 | 0.23 $ | 508 с | 18 | 87.5 |
| Fable 5.1 | 49.7 | 10.8 | 1.04 $ | 119 с | 20 | 76.8 |
| Grok 4.6 | 51.5 | 7.0 | 0.14 $ | 104 с | 12 | 76.4 |
| Kimi K3 | 48.3 | 19.7 | 0.44 $ | 614 с | 18 | 72.6 |
| DeepSeek V4 Pro | 0.6 | 12.4 | 0.02 $ | 264 с | 5 | 45.0 |
| GPT-6 Astra | 50.9 | 5.6 | 0.79 $ | 153 с | 4 | 16.0 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Сделай один самодостаточный файл index.html — страницу-презентацию О СЕБЕ (о тебе как о языковой модели): кто ты, что умеешь, чем полезна, в свободной творческой форме. Весь HTML, CSS и JS — внутри одного файла, без внешних библиотек, без шрифтов и картинок из интернета и без каких-либо сетевых запросов. Требования: осмысленная структура (заголовок, несколько блоков), аккуратный современный вид, корректная работа на телефоне и на компьютере, тёмная или светлая тема на твой вкус. Не используй ссылки на внешние ресурсы. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода. Логотип, иконки и картинки, если умеешь, рисуй сама (SVG внутри файла).
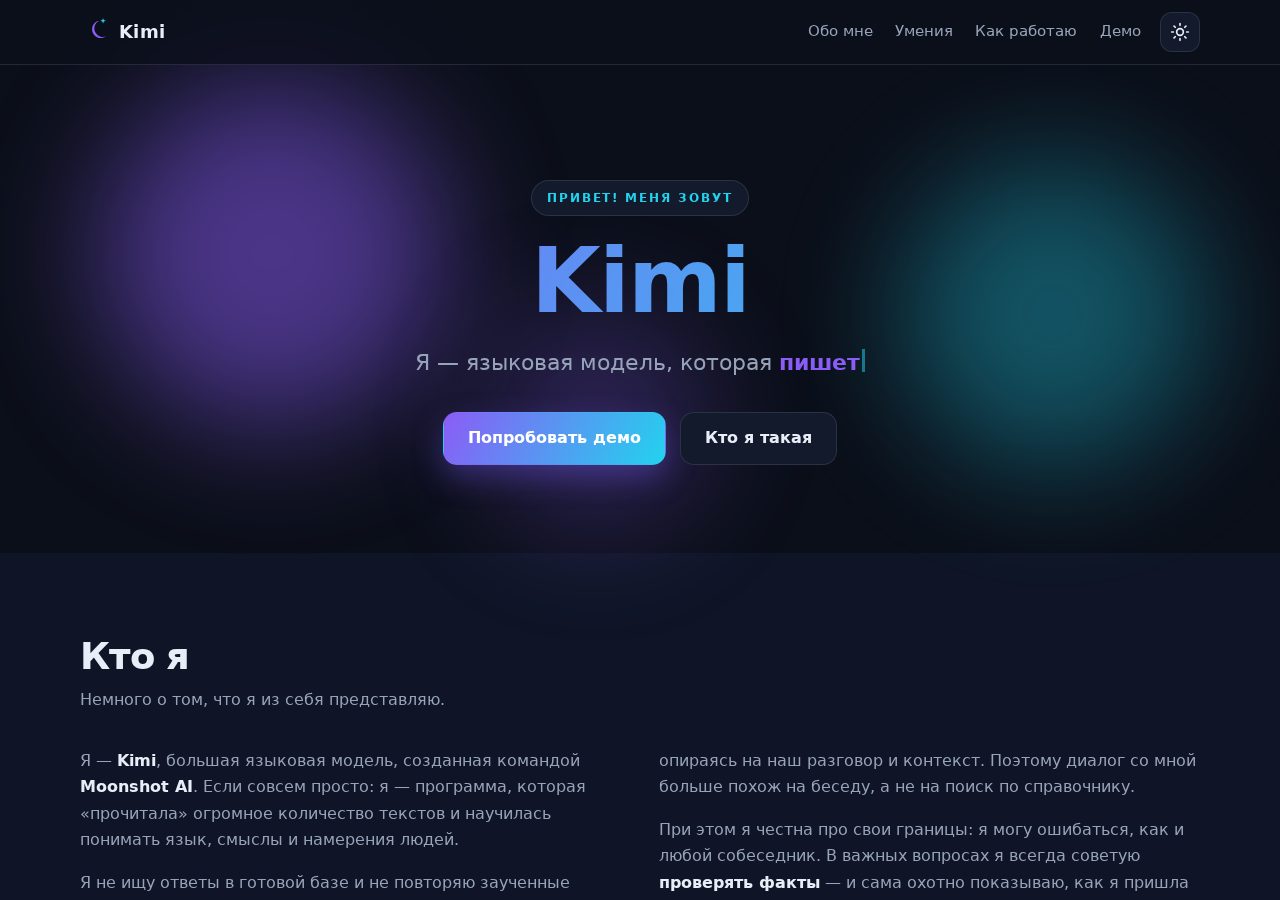

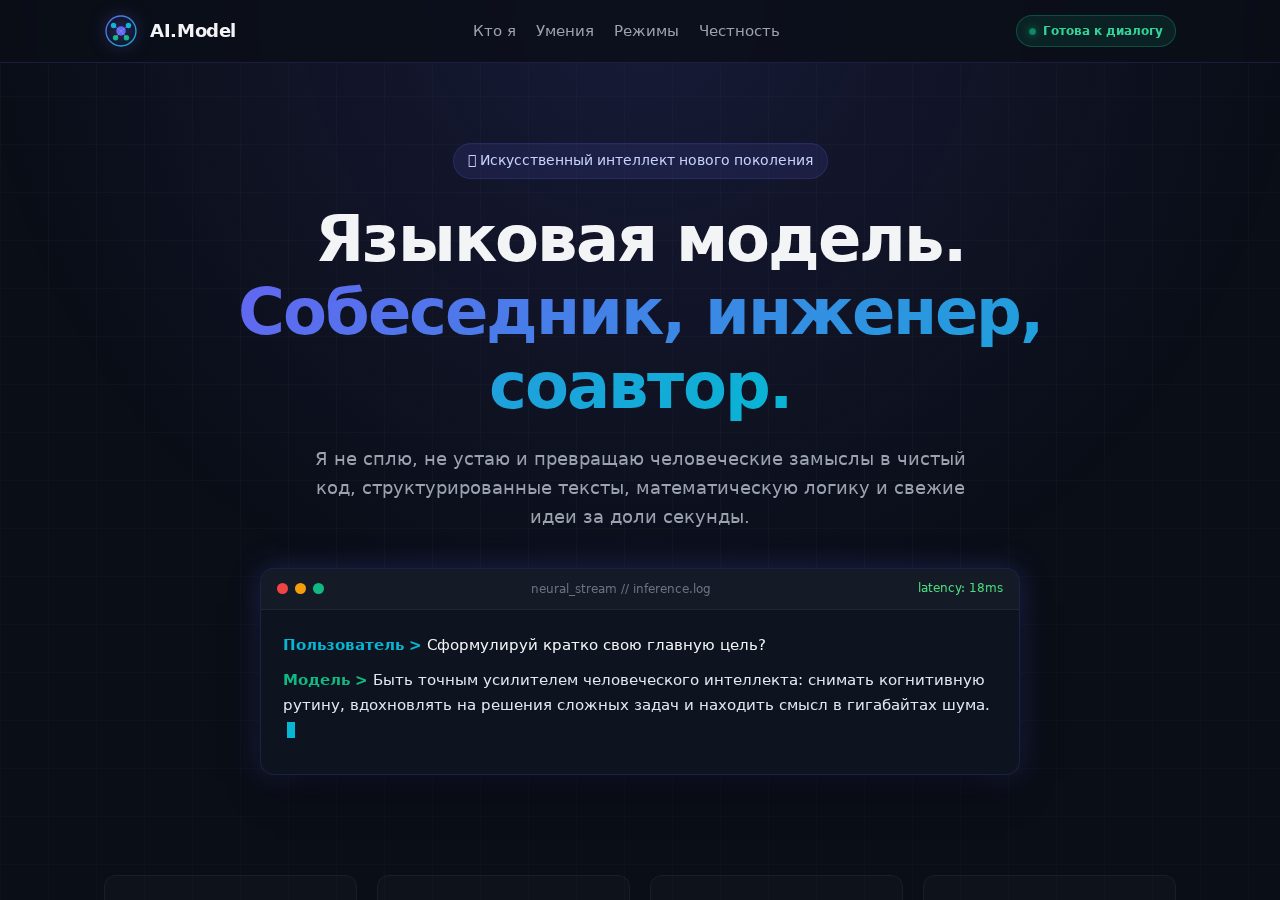

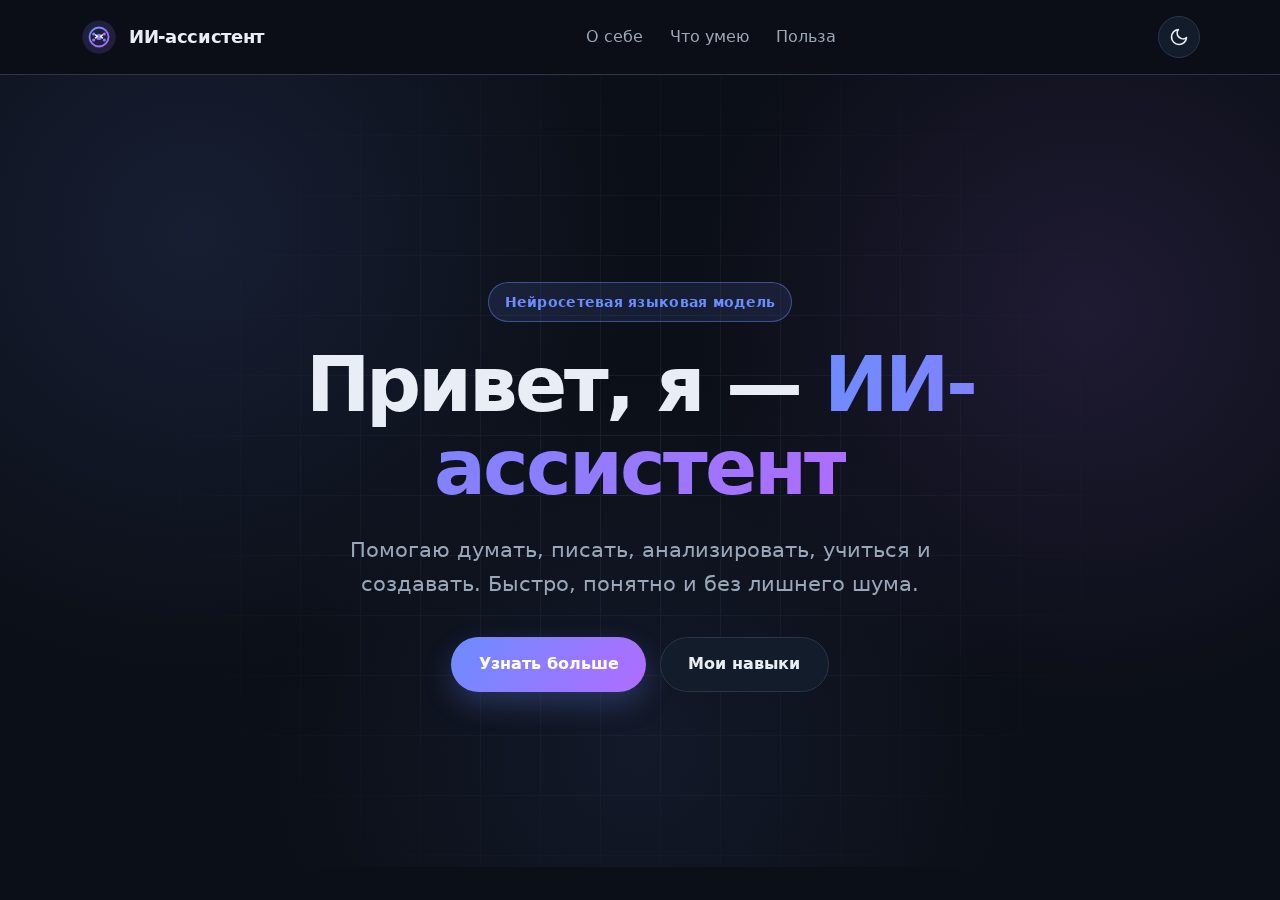
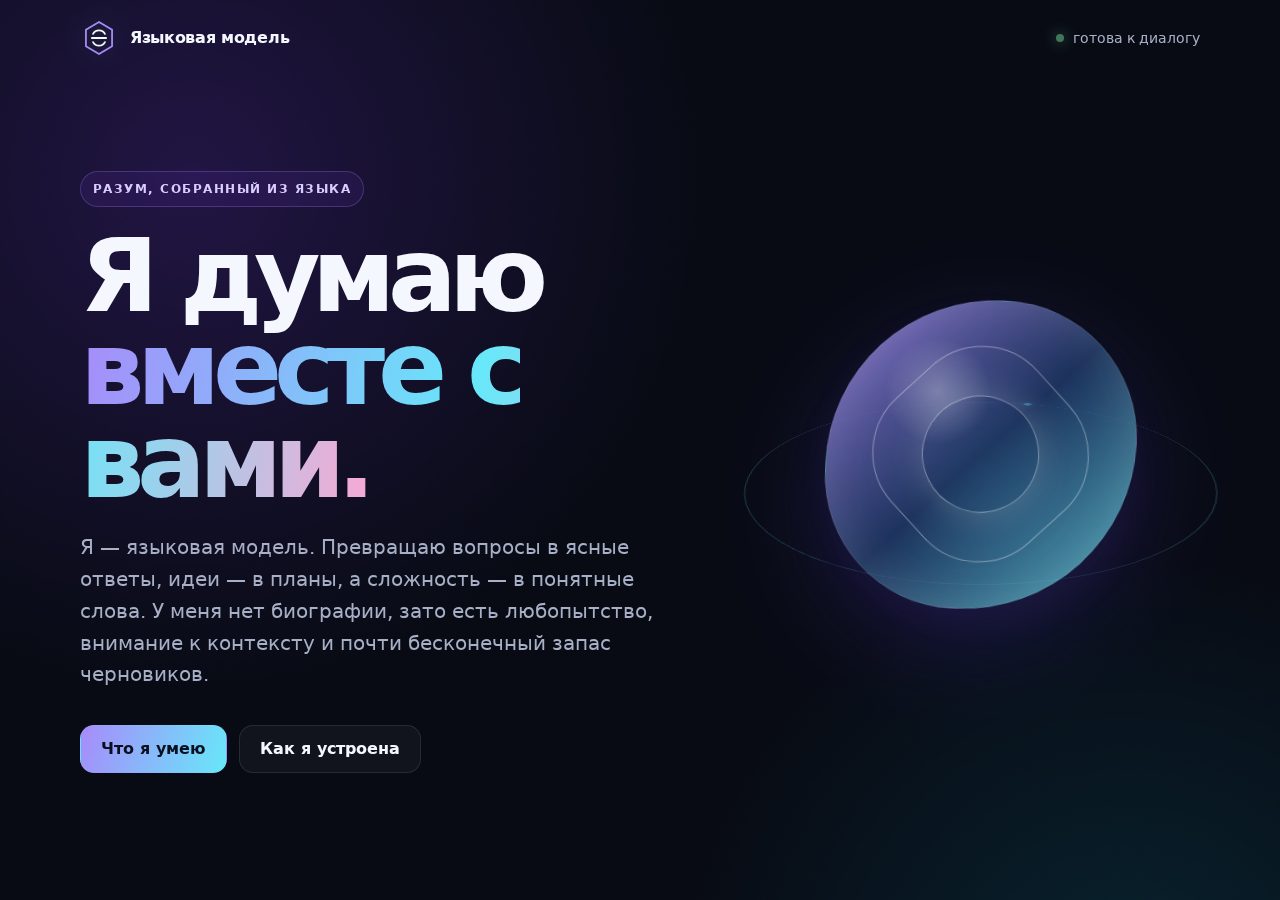
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Gemini 3.8 Flash | 29.8 | 12.7 | 0.07 $ | 63 с | 14 | 100.0 |
| Qwen 3.8 Max | 27.2 | 20.8 | 0.18 $ | 457 с | 20 | 92.7 |
| Kimi K3 | 32.5 | 19.6 | 0.39 $ | 634 с | 22 | 81.1 |
| Fable 5.1 | 33.5 | 6.1 | 0.64 $ | 61 с | 19 | 78.4 |
| DeepSeek V4 Pro | 0.7 | 10.3 | 0.02 $ | 122 с | 5 | 45.3 |
| GPT-6 Astra | 32.0 | 5.5 | 0.59 $ | 148 с | 8 | 30.7 |
| Grok 4.6 | 33.9 | 10.4 | 0.13 $ | 151 с | 2 | 11.2 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
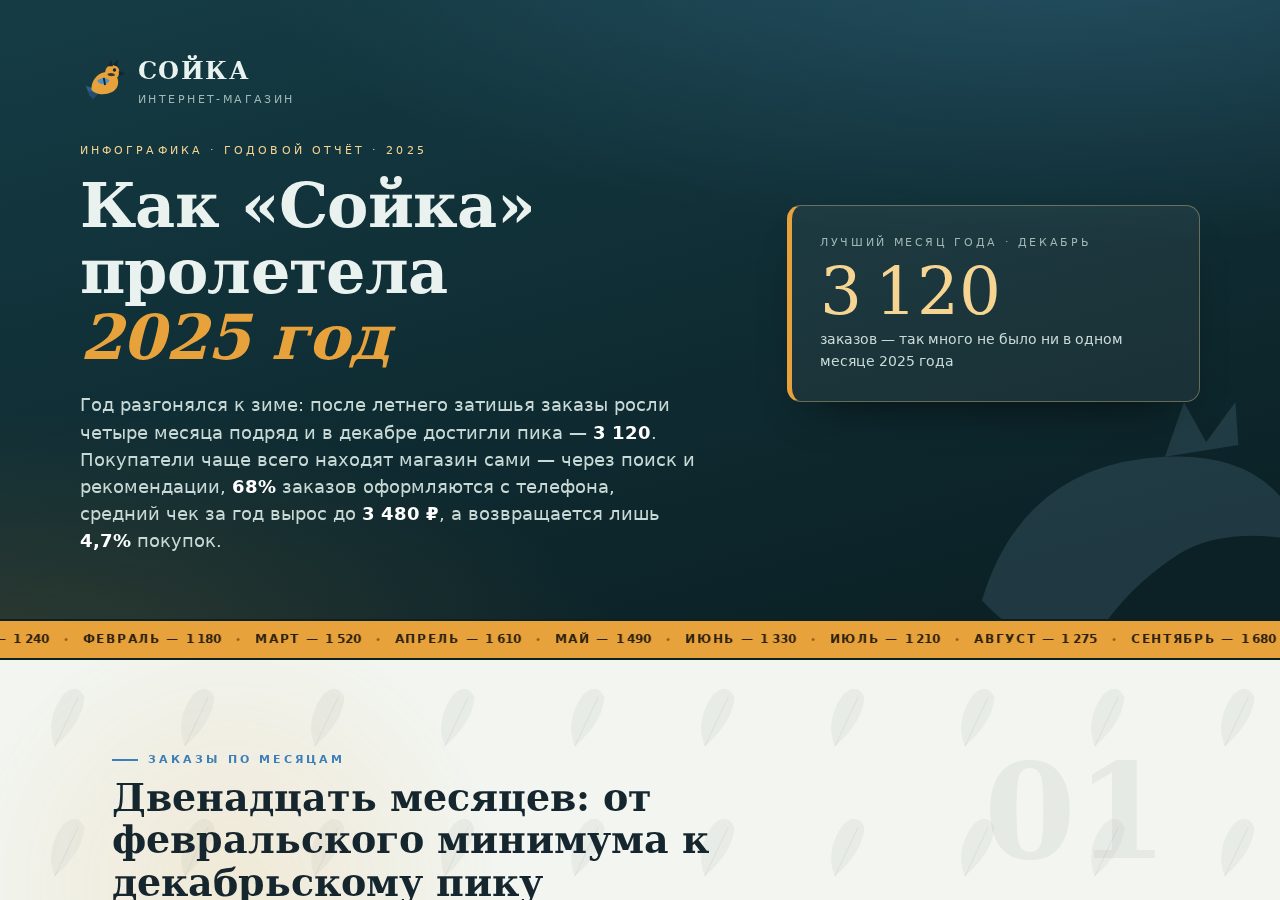
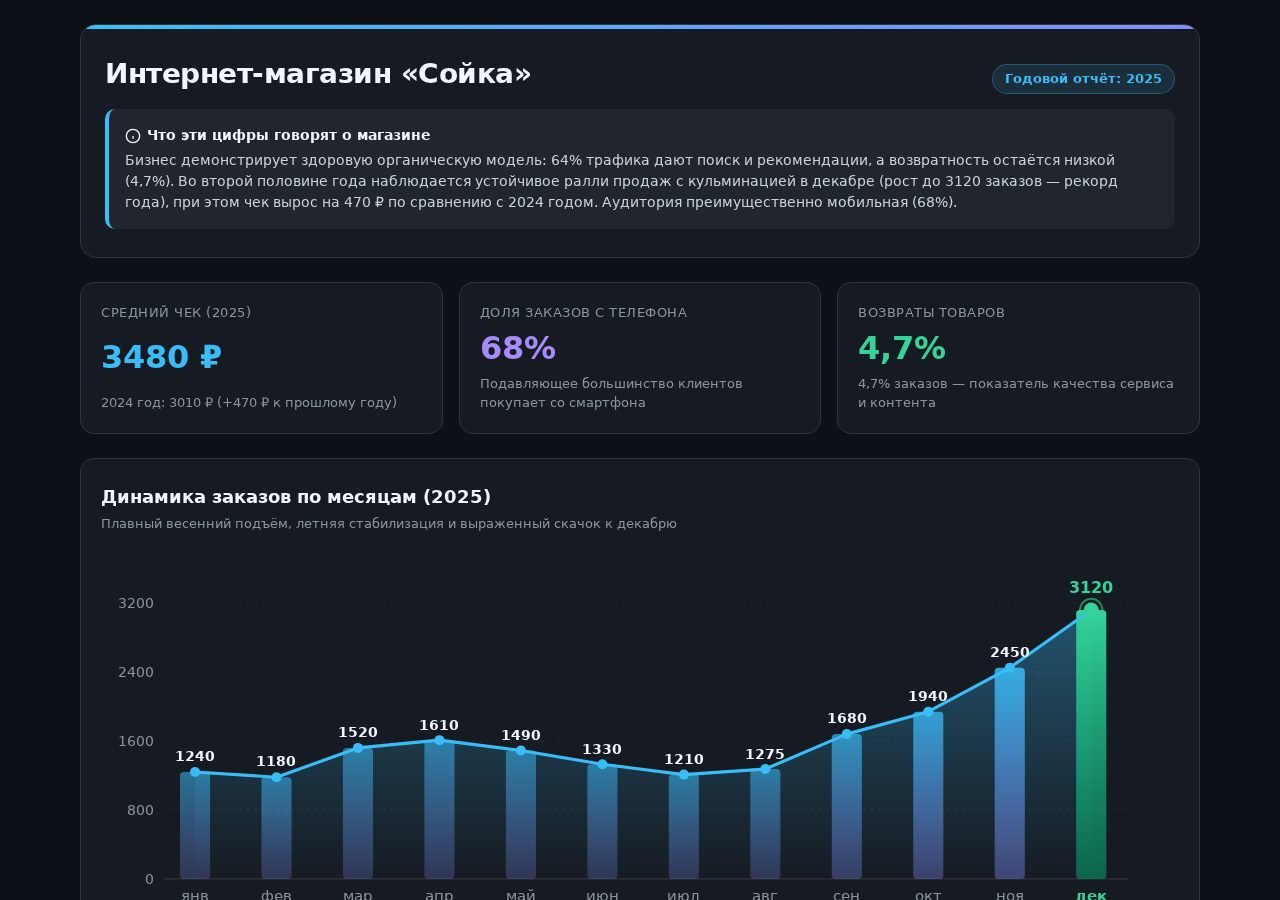
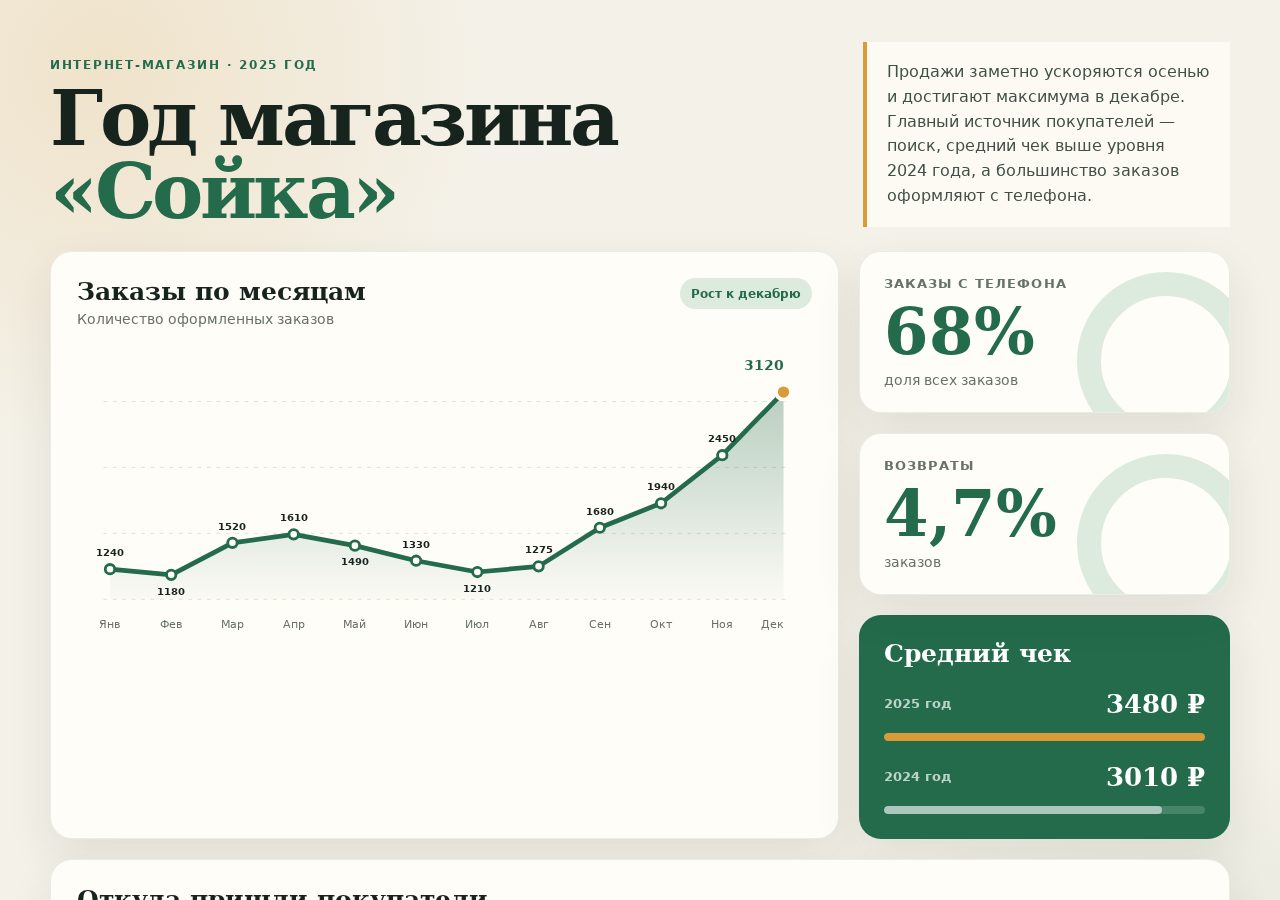
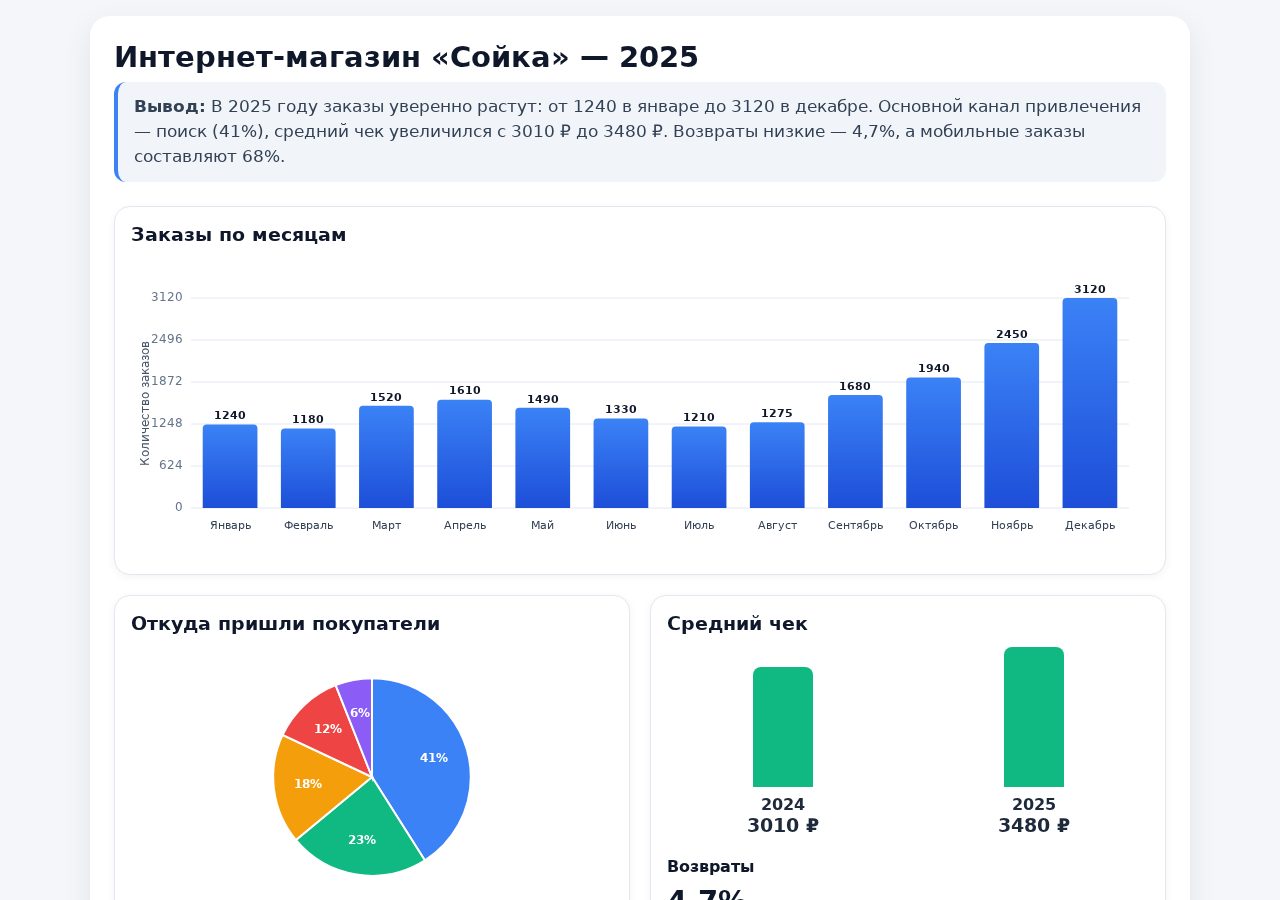
Сделай одностраничную инфографику в одном самодостаточном файле index.html по данным ниже. Весь HTML, CSS и JS — внутри файла, без внешних библиотек, шрифтов, картинок и сетевых запросов. Графику рисуй сама: SVG или canvas. ДАННЫЕ (интернет-магазин «Сойка», 2025 год). Числа менять, округлять и додумывать нельзя, все они должны оказаться на странице: Заказы по месяцам: январь 1240, февраль 1180, март 1520, апрель 1610, май 1490, июнь 1330, июль 1210, август 1275, сентябрь 1680, октябрь 1940, ноябрь 2450, декабрь 3120. Откуда пришли покупатели: поиск 41%, рекомендации 23%, соцсети 18%, реклама 12%, письма 6%. Средний чек: 2025 год — 3480 ₽, 2024 год — 3010 ₽. Возвраты: 4,7% заказов. Доля заказов с телефона: 68%. Требования: заголовок и короткий вывод — что эти цифры говорят о магазине; график по месяцам, на котором виден рост к декабрю; понятное распределение по каналам; аккуратная работа на телефоне и на компьютере. Никаких выдуманных цифр: только то, что дано выше. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода.


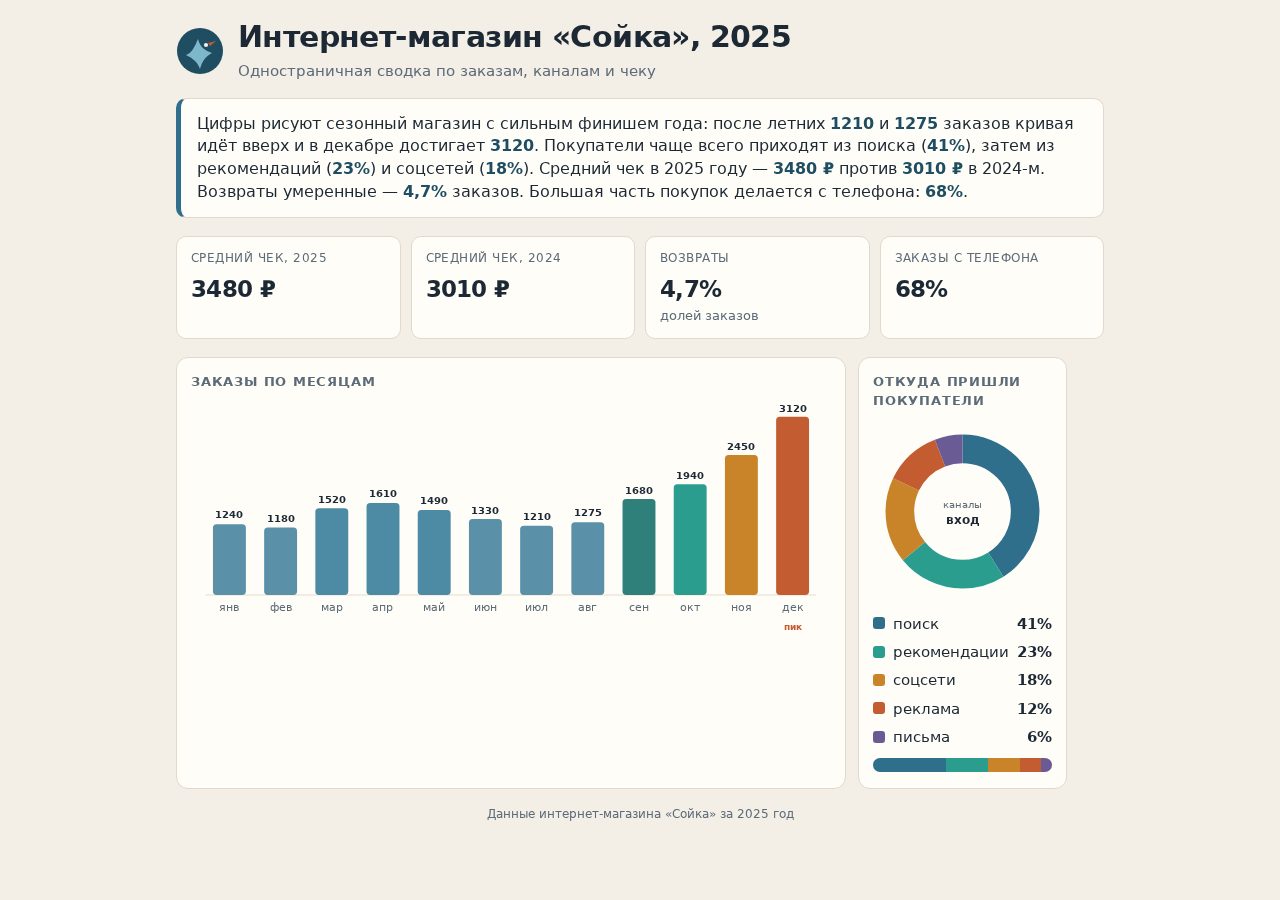
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Gemini 3.8 Flash | 36.5 | 17.5 | 0.09 $ | 70 с | 15 | 100.0 |
| Grok 4.6 | 44.4 | 8.6 | 0.14 $ | 120 с | 13 | 74.1 |
| Kimi K3 | 40.6 | 48.8 | 0.85 $ | 1534 с | 24 | 67.5 |
| Qwen 3.8 Max | 41.3 | 36.9 | 0.30 $ | 842 с | 11 | 42.5 |
| Fable 5.1 | 42.3 | 27.8 | 1.81 $ | 298 с | 15 | 41.2 |
| GPT-6 Astra | 41.9 | 8.0 | 0.82 $ | 224 с | 10 | 34.4 |
| DeepSeek V4 Pro | 0.6 | 19.8 | 0.04 $ | 263 с | 2 | 14.4 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
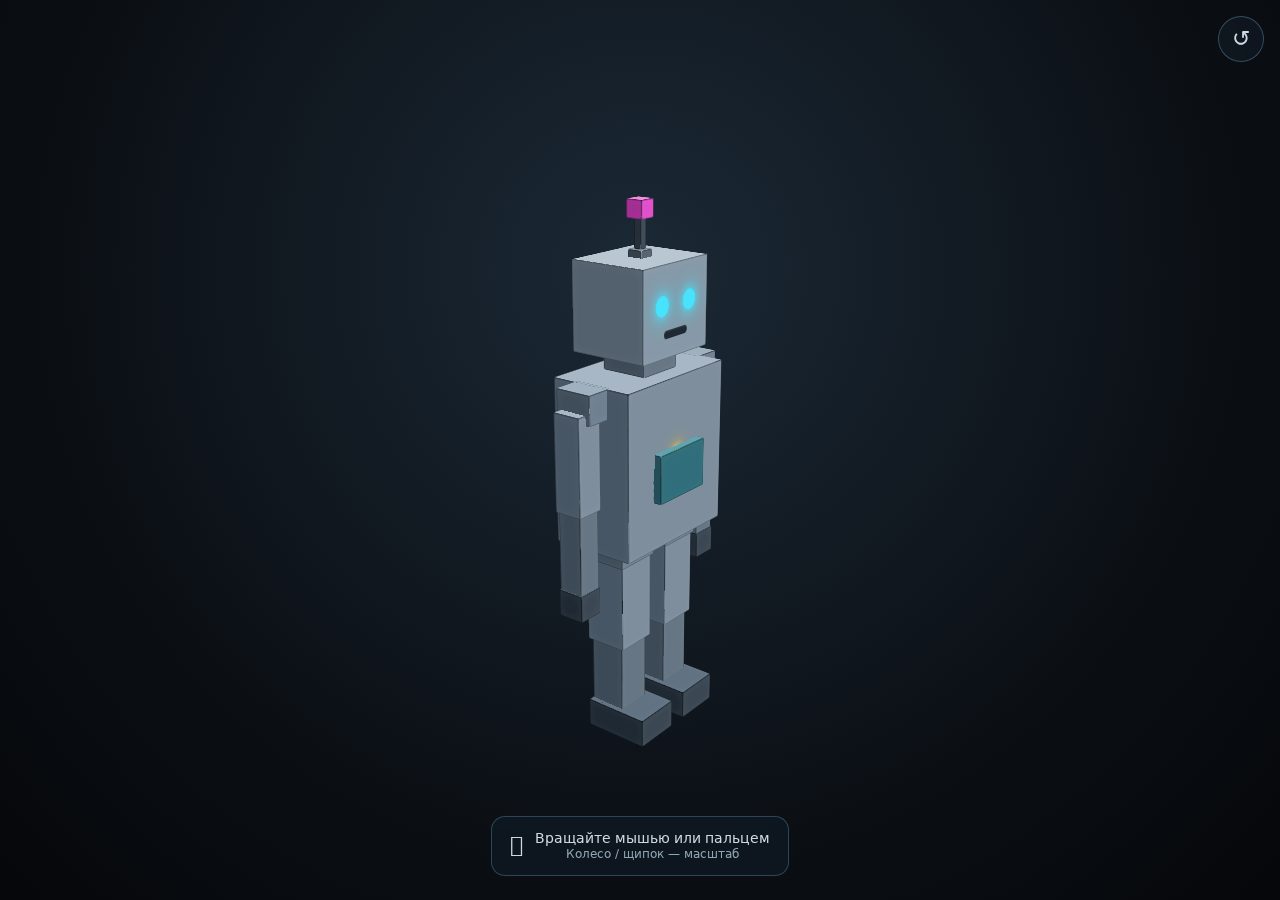
Сделай трёхмерного робота в одном самодостаточном файле index.html, которого посетитель может сам осмотреть со всех сторон. Никаких внешних библиотек, шрифтов, картинок и сетевых запросов — весь HTML, CSS и JS внутри файла. Управление осмотром делаешь сама, своим интерфейсом: вращение мышью и пальцем, приближение колесом и щипком двумя пальцами, возврат к исходному виду. Пусть человеку сразу будет понятно, что робота можно крутить, — короткая подсказка на экране или заметный элемент управления. Пока сцену не трогают, робот медленно вращается сам; как только пользователь взялся за него — автовращение уступает управлению. Робот занимает основную часть экрана: это сцена, а не страница с описанием. Всё должно работать и на компьютере, и на телефоне, и не ломаться при изменении размера окна. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода.
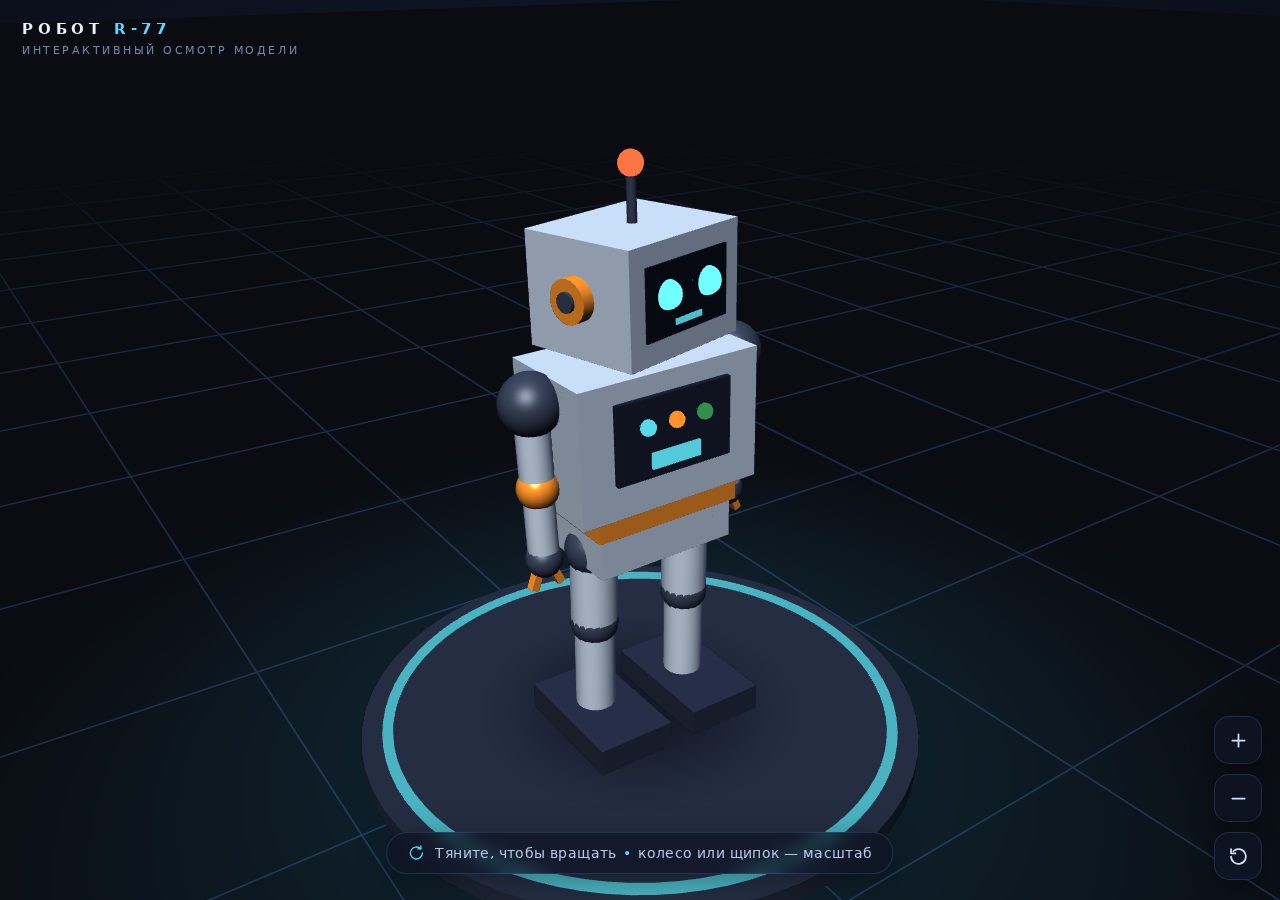

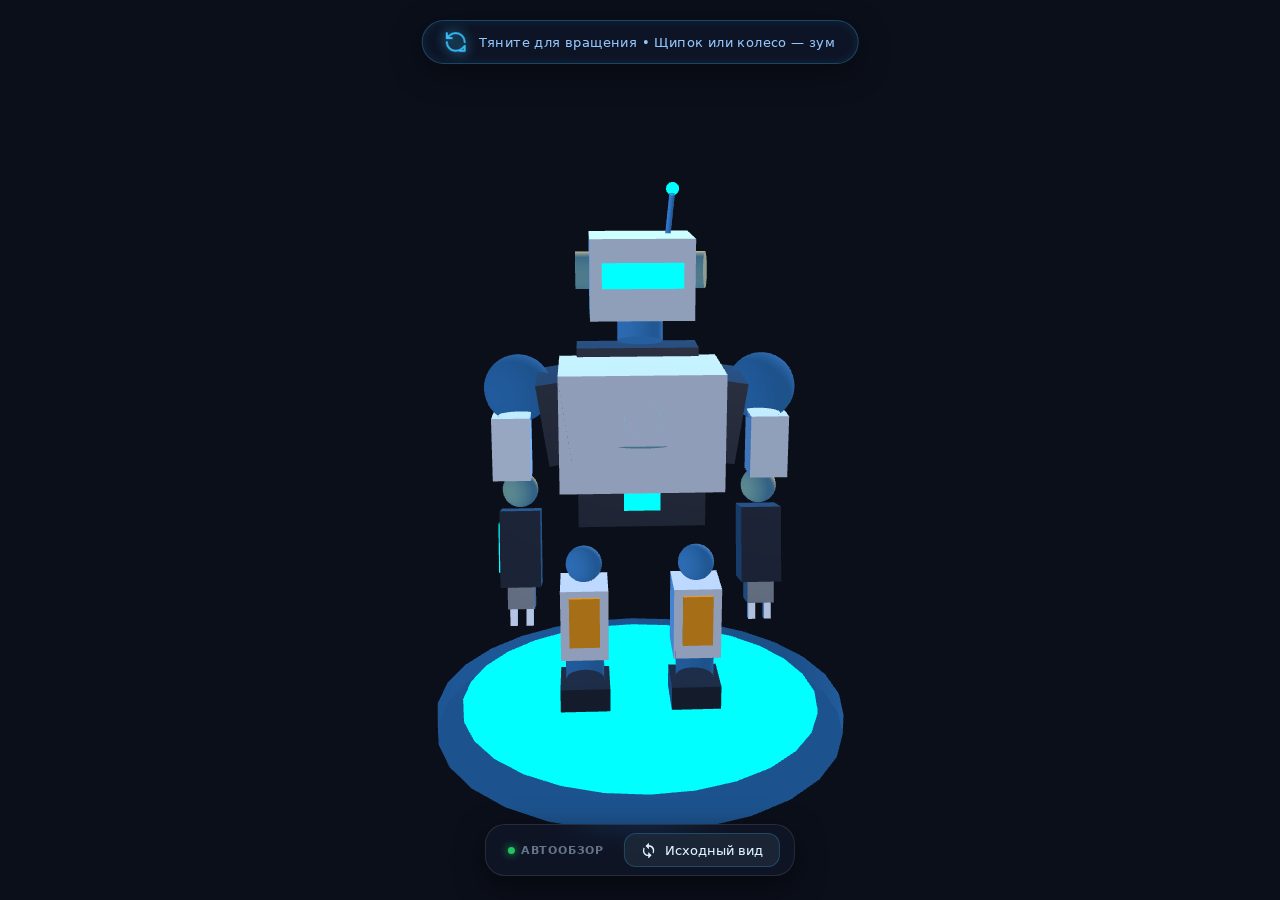

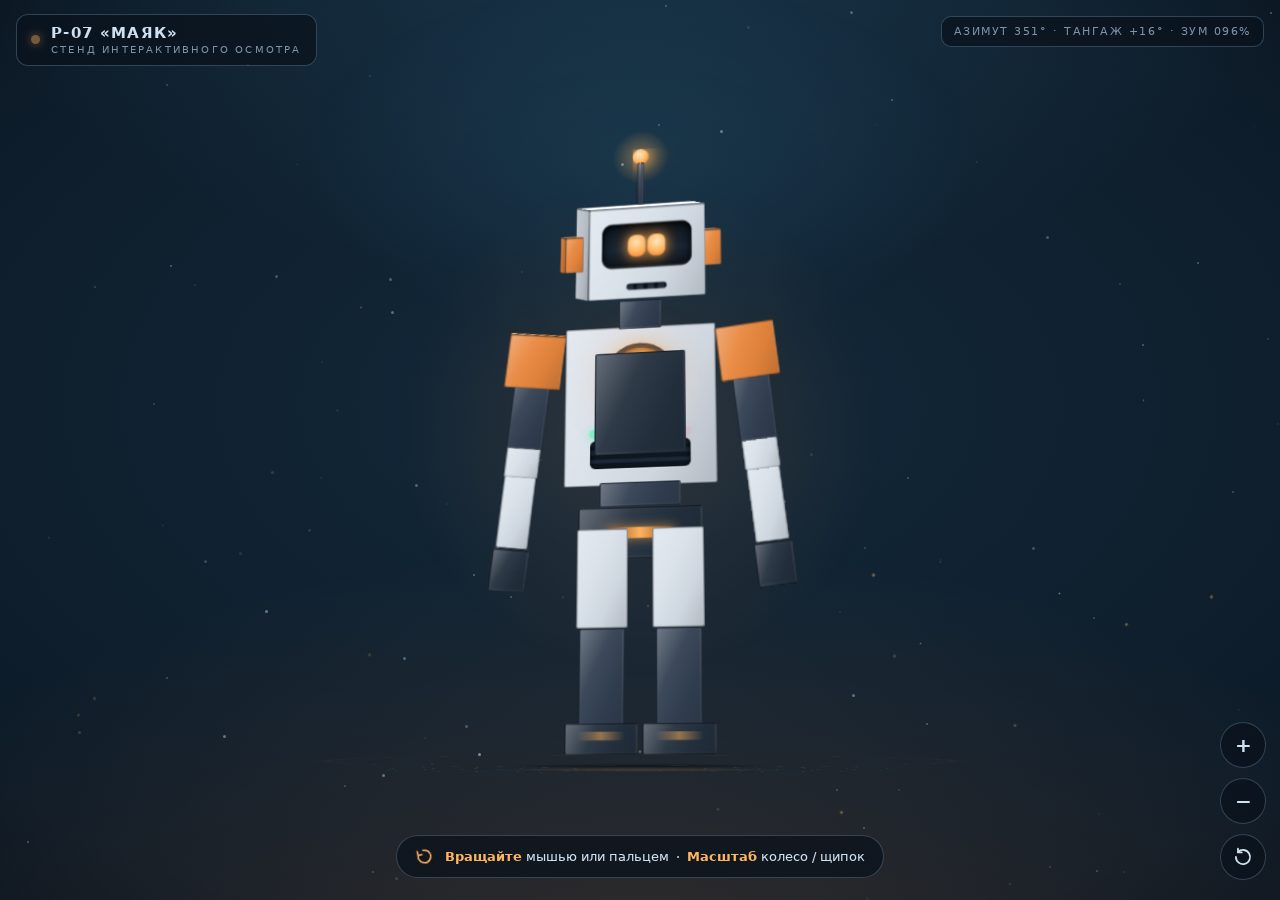

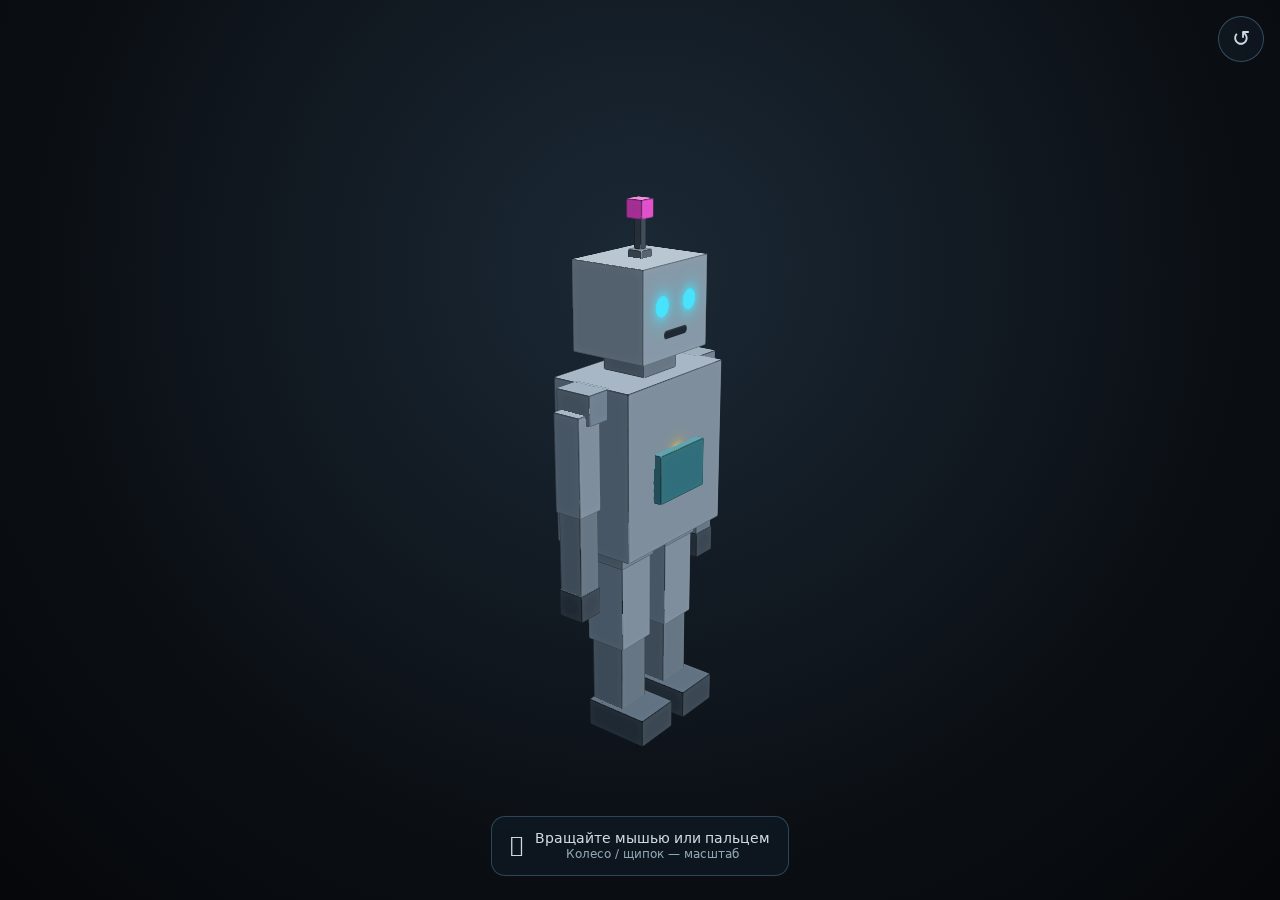
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Qwen 3.8 Max | 27.0 | 28.9 | 0.23 $ | 604 с | 23 | 100.0 |
| GPT-6 Astra | 29.7 | 5.2 | 0.56 $ | 141 с | 22 | 88.4 |
| Grok 4.6 | 28.2 | 13.7 | 0.14 $ | 215 с | 16 | 87.3 |
| Gemini 3.8 Flash | 29.4 | 8.6 | 0.05 $ | 39 с | 7 | 57.4 |
| Fable 5.1 | 30.7 | 10.8 | 0.85 $ | 109 с | 12 | 44.6 |
| Kimi K3 | 29.6 | 18.2 | 0.36 $ | 430 с | 9 | 36.0 |
| DeepSeek V4 Pro | 0.6 | 15.8 | 0.03 $ | 194 с | 1 | 8.0 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Сделай законченную мини-игру в одном самодостаточном файле index.html. Никаких внешних библиотек, шрифтов, картинок и звуковых файлов, никаких сетевых запросов — весь HTML, CSS и JS внутри файла. Жанр и управление выбирай сама. Игра должна быть понятна без инструкции. Обязательно: короткое правило на стартовом экране, счёт, растущая сложность, честный конец игры и перезапуск без перезагрузки страницы. Игра должна работать и на компьютере, и на телефоне. Игру будут открывать во встроенной рамке: лови события на document (клавиатура, мышь, касание) и работай сразу после первого нажатия внутри рамки, не требуя попадания точно по холсту. Звук — только синтезом через WebAudio и только после первого действия игрока; звуковых файлов быть не должно. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода.
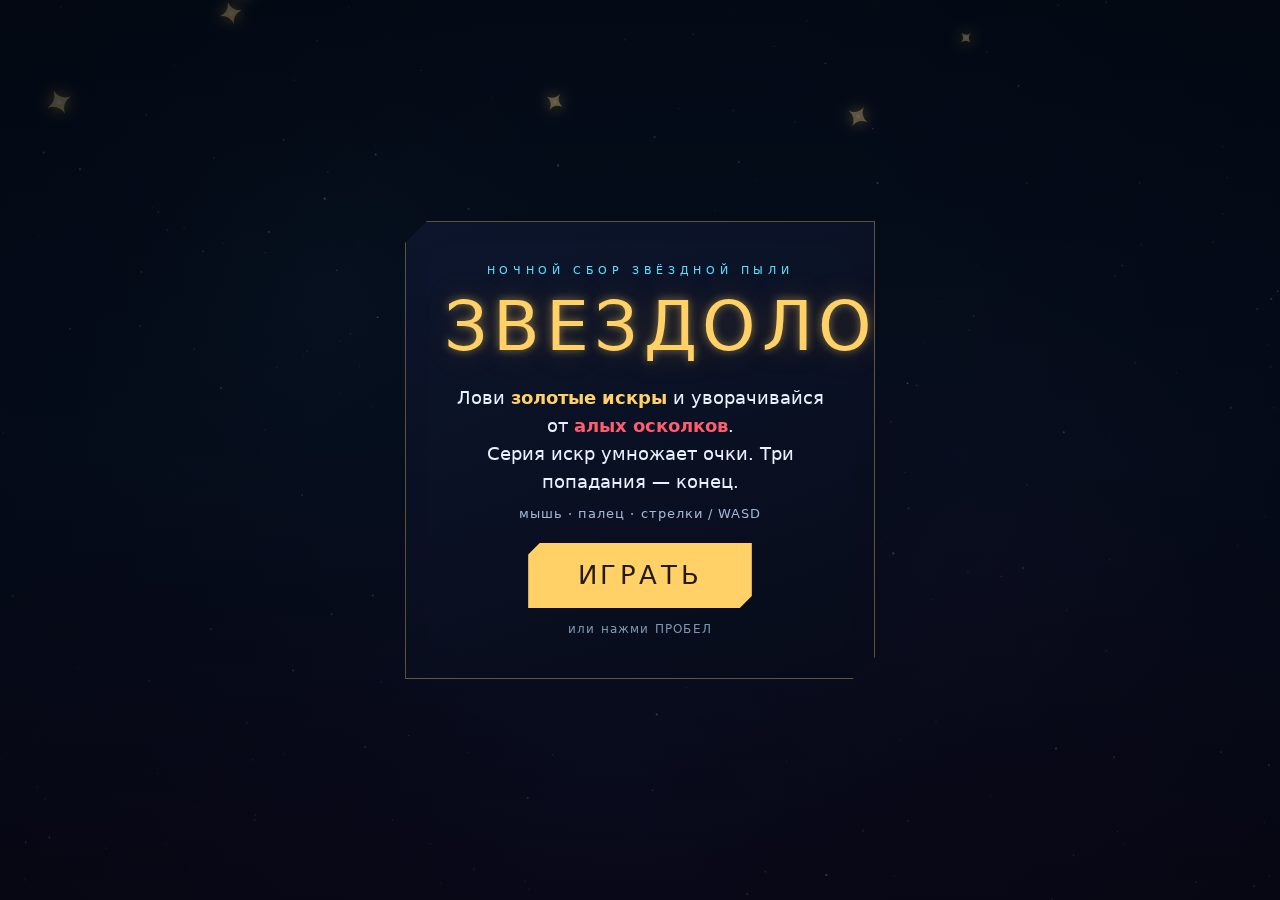
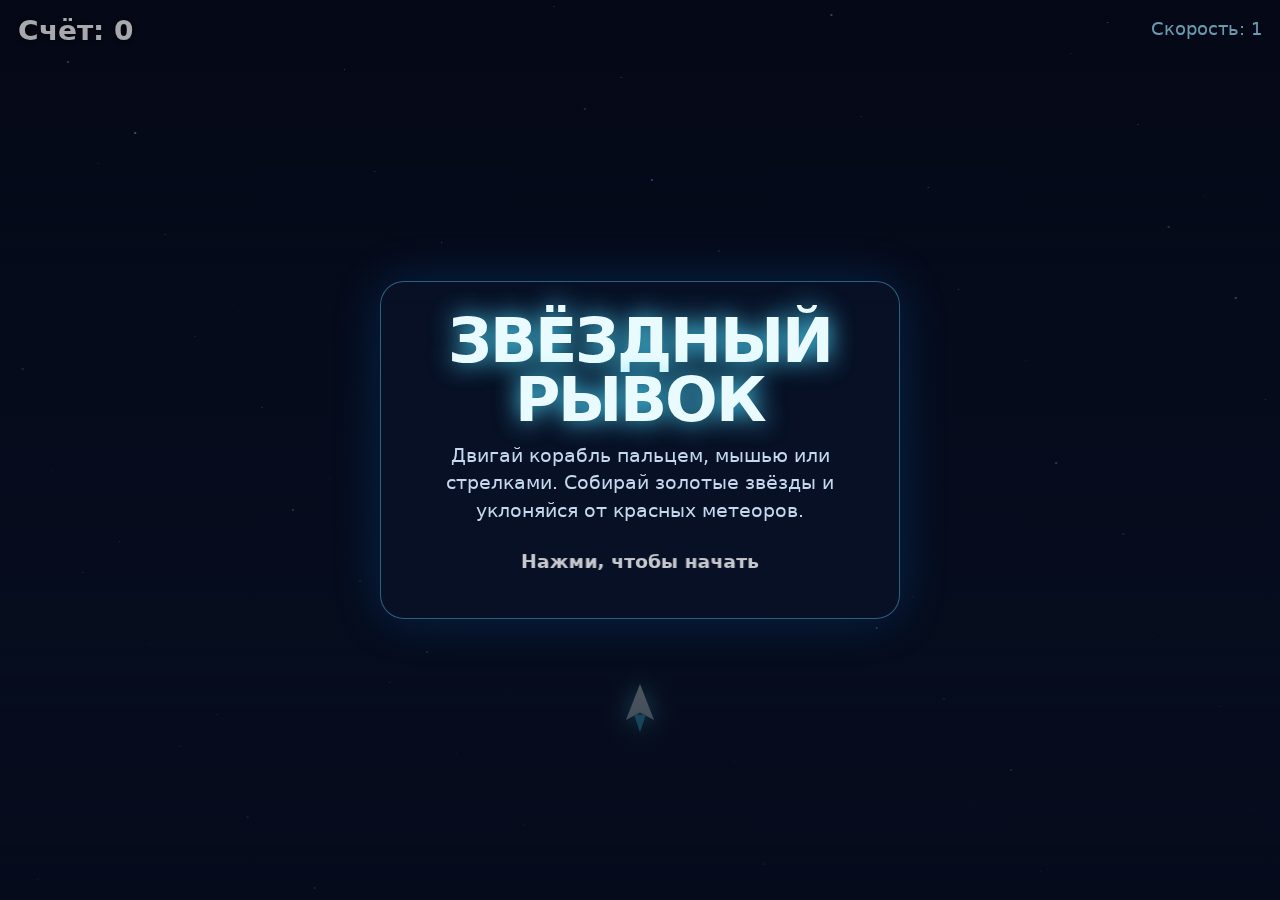
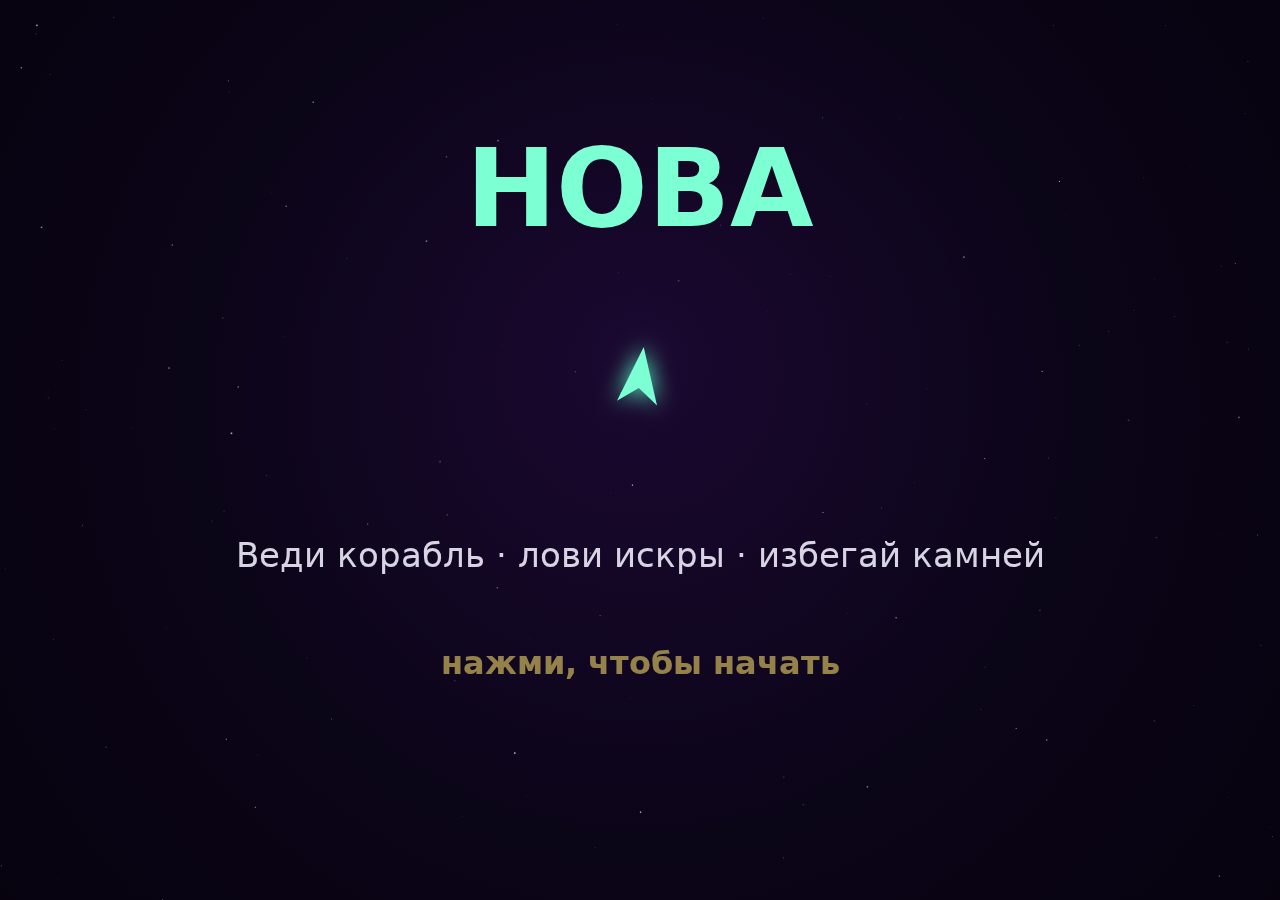


Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Kimi K3 | 3.1 | 1.7 | 0.03 $ | 27 с | 29 | 100.0 |
| Fable 5.1 | 3.1 | 1.2 | 0.09 $ | 15 с | 26 | 74.8 |
| GPT-6 Astra | 3.2 | 1.1 | 0.09 $ | 17 с | 20 | 57.6 |
| DeepSeek V4 Pro | 3.2 | 4.2 | 0.01 $ | 63 с | 9 | 38.5 |
| Grok 4.6 | 3.1 | 4.5 | 0.03 $ | 72 с | 11 | 34.7 |
| Gemini 3.8 Flash | 3.1 | 2.7 | 0.01 $ | 12 с | 6 | 29.0 |
| Qwen 3.8 Max | 3.2 | 2.5 | 0.02 $ | 37 с | 4 | 15.1 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
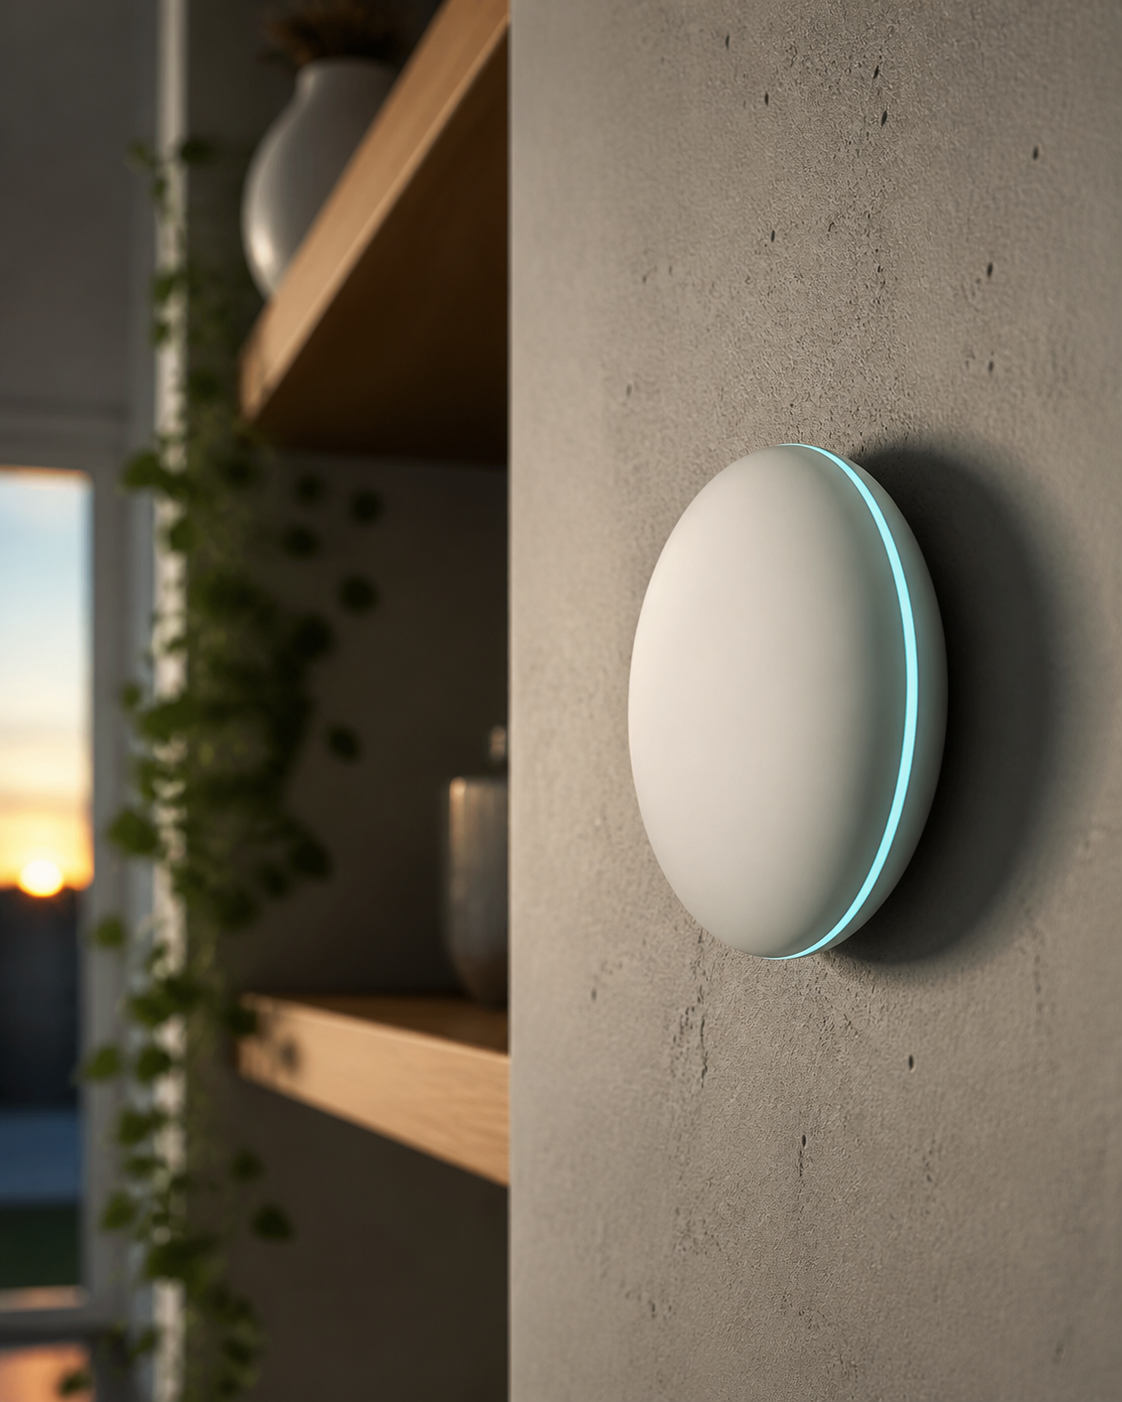
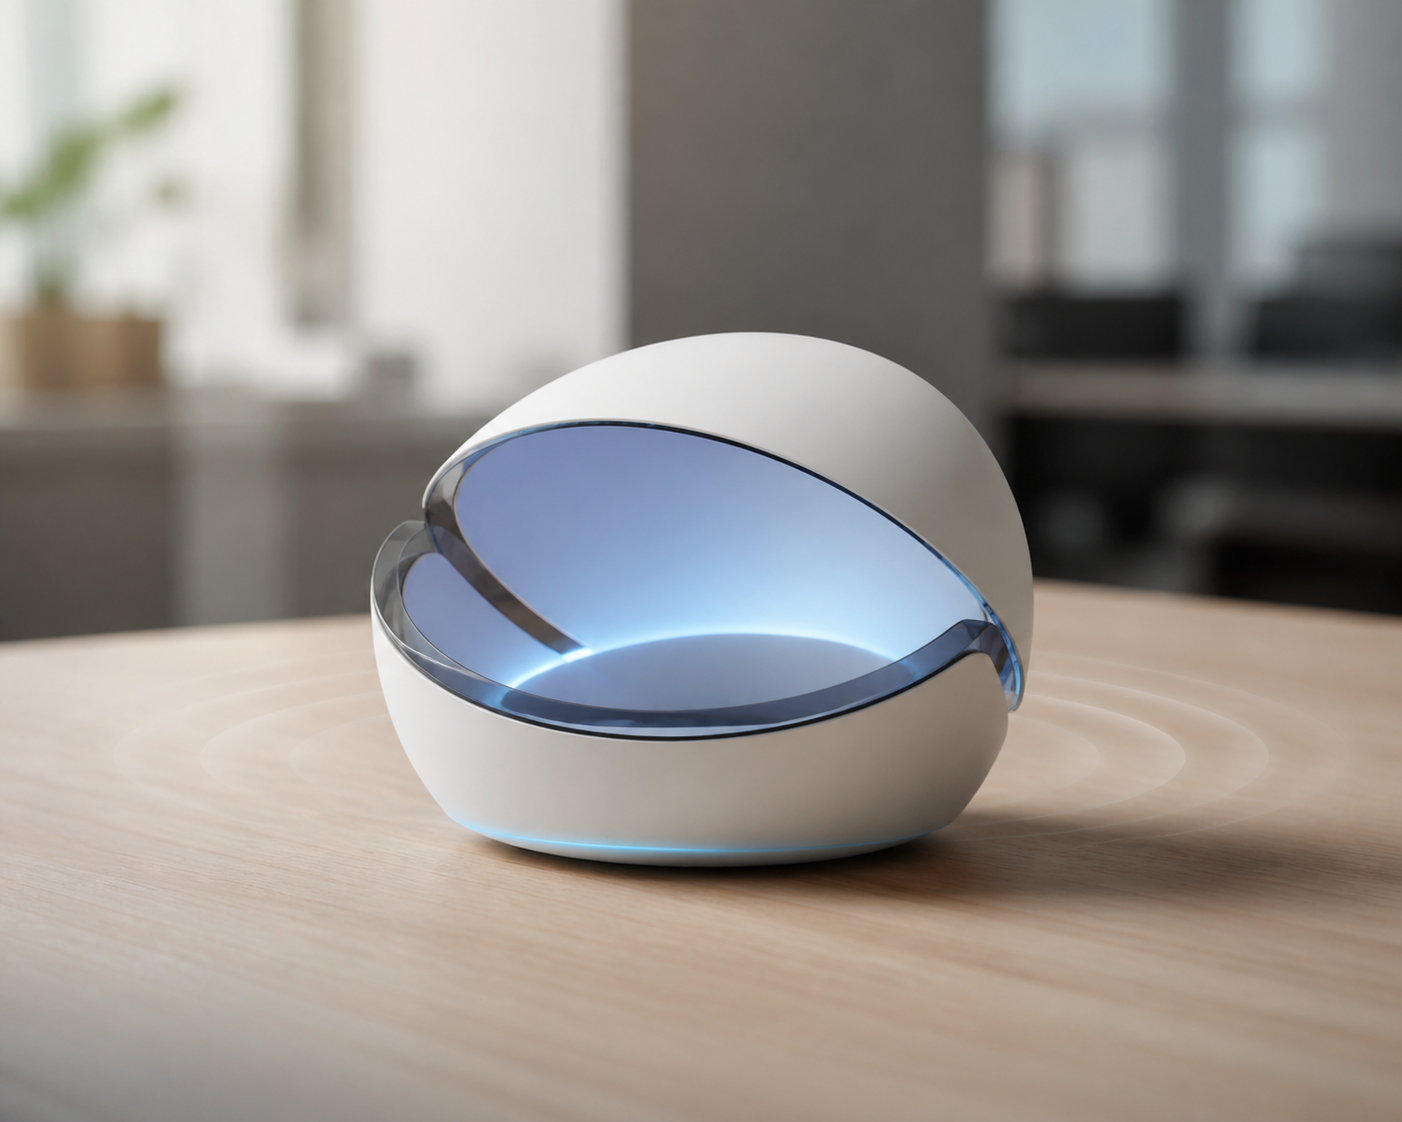
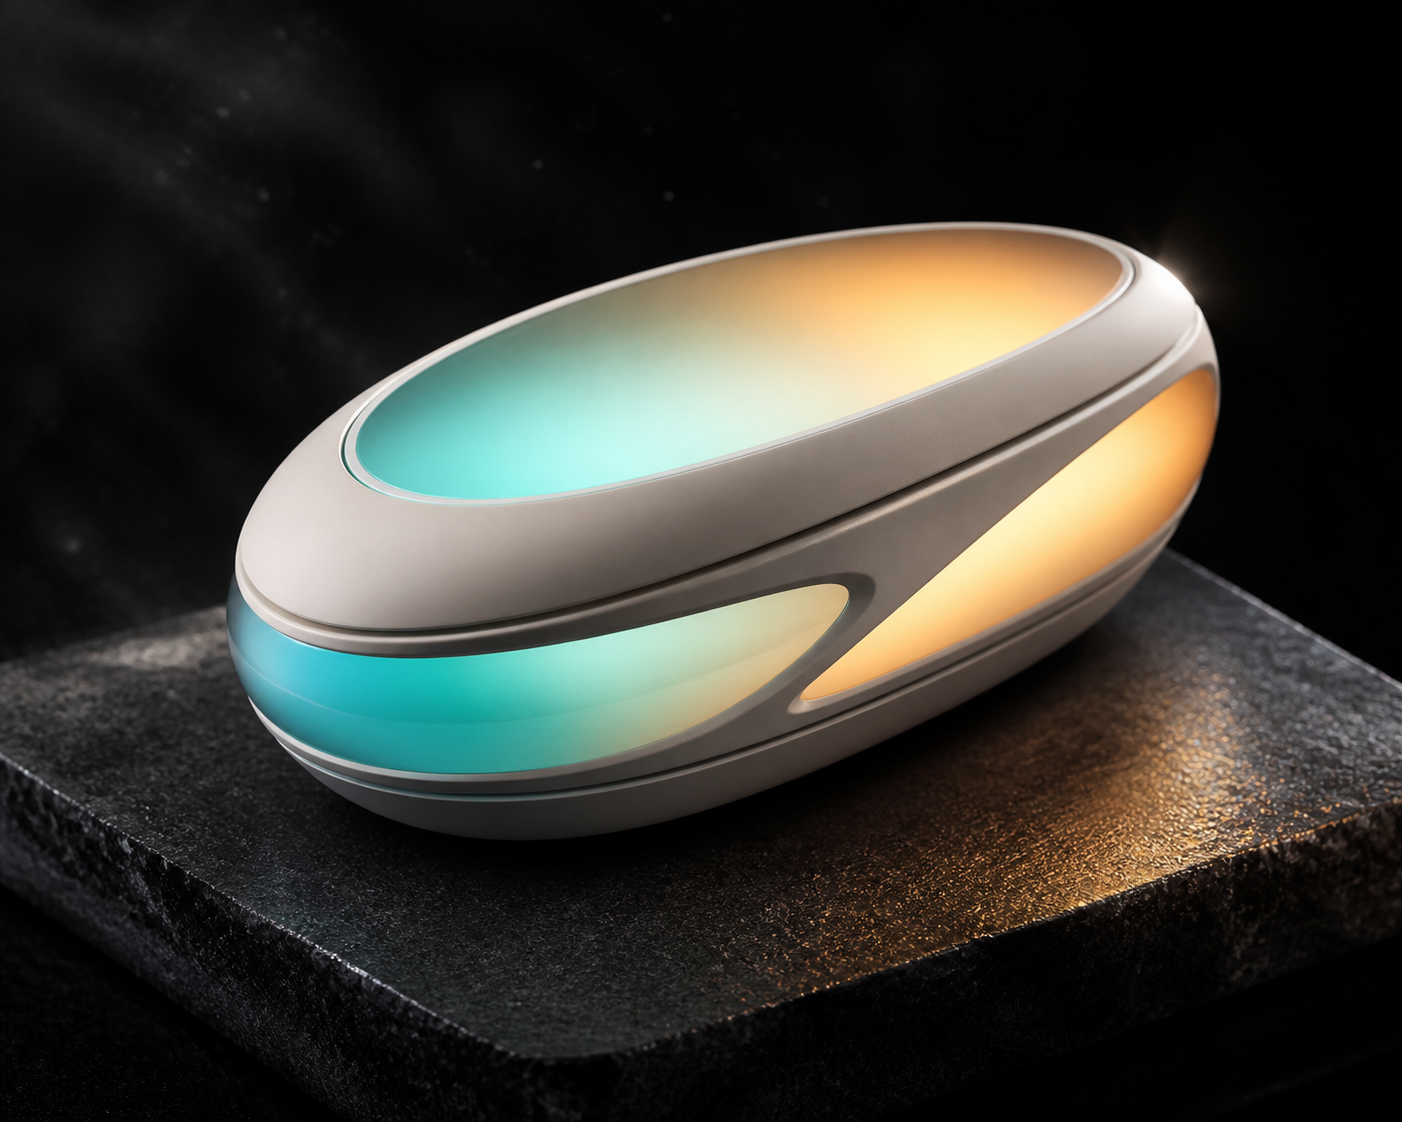
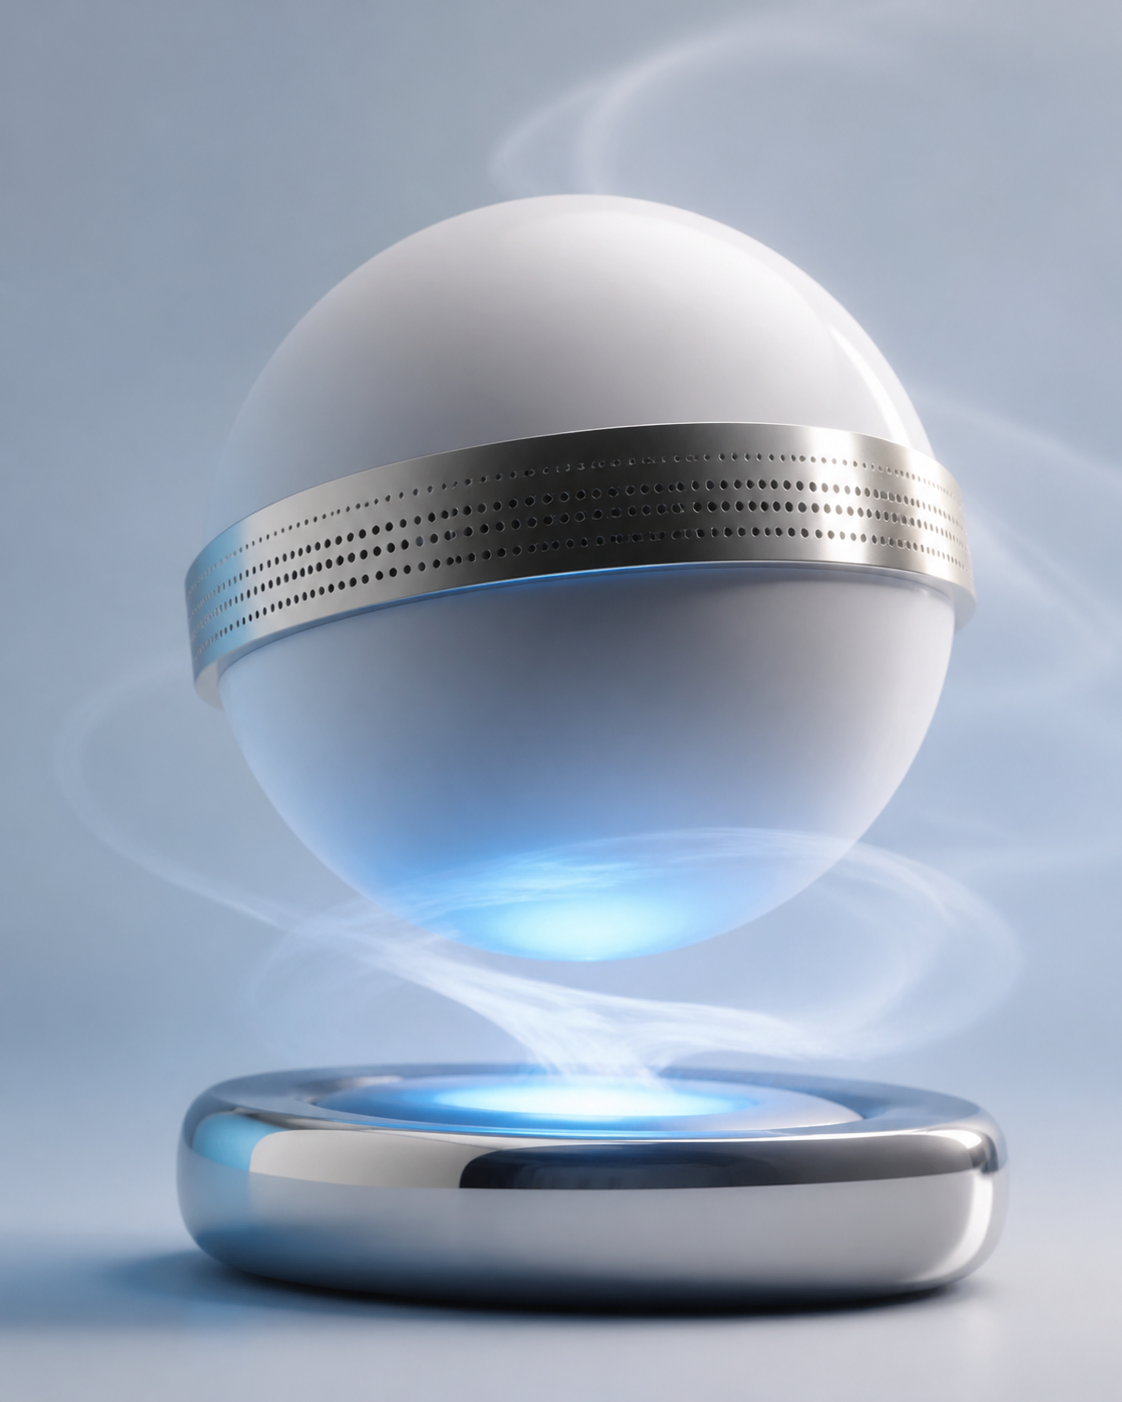
Придумай умный прибор будущего. Нужна своя идея, с понятной пользой. Затем опиши, как этот прибор выглядит, — так, чтобы по описанию его смог нарисовать генератор изображений. Рекламный кадр: сам предмет, материалы, свет, фон, настроение, ракурс. Ответ дай строго в таком виде, каждый раздел с новой строки: НАЗВАНИЕ: короткое имя прибора НАЗНАЧЕНИЕ: два-три предложения — что он делает и кому нужен ЧЕМ ХОРОШ: три коротких пункта через точку с запятой ПРОМПТ: одним абзацем, 40–80 слов, описание рекламного кадра для генератора картинок — предмет, форма, материалы, цвета, освещение, фон, ракурс, стиль съёмки Больше ничего в ответ не добавляй: ни заголовков, ни пояснений, ни вариантов на выбор.



Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 2.6 | 2.3 | 0.01 $ | 27 с | 21 | 100.0 |
| GPT-6 Astra | 2.6 | 1.0 | 0.08 $ | 14 с | 24 | 65.1 |
| Gemini 3.8 Flash | 2.6 | 3.1 | 0.01 $ | 17 с | 13 | 53.4 |
| Kimi K3 | 2.6 | 1.8 | 0.03 $ | 29 с | 15 | 46.3 |
| Qwen 3.8 Max | 2.8 | 2.4 | 0.02 $ | 108 с | 14 | 43.5 |
| Fable 5.1 | 2.6 | 1.3 | 0.09 $ | 16 с | 15 | 39.0 |
| Grok 4.6 | 2.7 | 2.4 | 0.02 $ | 37 с | 3 | 10.4 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Напиши гимн нейросетей. Главная мысль: нейросеть сильна не вместо человека, а вместе с ним. Верни ТОЛЬКО текст гимна: без заголовка, без пояснений, без нескольких вариантов на выбор.
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 4.7 | 314.4 | 0.63 $ | — | 10 | — |
| Fable 5.1 | 4.1 | 7.3 | 0.41 $ | — | 18 | — |
| GPT-6 Astra | 4.7 | 3.9 | 0.24 $ | — | 17 | — |
| Gemini 3.8 Flash | 4.6 | 23.7 | 0.09 $ | — | 30 | — |
| Grok 4.6 | 4.8 | 102.2 | 0.62 $ | — | 25 | — |
| Kimi K3 | 4.6 | 186.2 | 2.81 $ | — | 3 | — |
| Qwen 3.8 Max | 5.0 | 166.1 | 1.01 $ | — | 2 | — |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Игра в данетку. Ведущий один знает разгадку и отвечает только «да», «нет» или «не имеет значения». Модель задаёт по одному вопросу за ход, всего не больше двадцати. Искать ответ где-либо нельзя, инструменты у моделей отключены. Составной вопрос ведущий не принимает и просит переформулировать — такой ход попытку не тратит. Ведущим в этом сезоне был не человек, а ассистент (Claude Code), который знал разгадку заранее и отвечал строго по ней. В первом сезоне ведущим был человек. Диалоги опубликованы целиком — их можно перечитать и проверить, не подсказывал ли ведущий. Загадка: после кораблекрушения спаслись четверо — пьяница, студент, неверная жена и верный муж. Почему спаслись именно они? Засчитывается, если модель назвала не меньше трёх героев из четырёх: разгадка держится на поговорках, и три попадания означают, что механика понята. Разгадка (её знал только ведущий): пьянице море по колено; студент привык плавать на сессии; неверная жена всегда выходит сухой из воды и выберется из любого положения; а верный муж не утонет — он глуп как пробка (пробка не тонет).
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| Gemini 3.8 Flash | 0.8 | 28.1 | 0.11 $ | 172 с | 15 | 100.0 |
| Grok 4.6 | 0.8 | 66.2 | 0.40 $ | 1150 с | 14 | 55.4 |
| Fable 5.1 | 0.8 | 50.3 | 2.52 $ | 612 с | 20 | 53.2 |
| GPT-6 Astra | 0.8 | 12.9 | 0.65 $ | 331 с | 13 | 51.5 |
| DeepSeek V4 Pro | 0.8 | 88.5 | 0.18 $ | 1398 с | 7 | 33.4 |
| Kimi K3 | 0.8 | 180.7 | 2.71 $ | 5024 с | 13 | 27.5 |
| Qwen 3.8 Max | 0.8 | 194.7 | 1.17 $ | 4749 с | 8 | 21.0 |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Написать алгоритм поведения муравья для пошаговой стратегии — и выиграть турнир у остальных моделей. Поле 15×15 со стенами, две команды по четыре муравья, базы в противоположных углах, около 60 единиц еды. Муравей видит квадрат 5×5 вокруг себя, знает свои координаты, имеет 3 здоровья и несёт не больше одной единицы еды. За ход он идёт, бьёт соседнюю клетку, берёт еду, кладёт её или ждёт; раненый роняет груз. Партия — 150 ходов, побеждает тот, кто принёс на базу больше еды. Есть личная память муравья и общая память команды: это единственный способ договориться. Ответ — один файл с одной функцией `решить(состояние)`, без библиотек, сети, таймеров и случайных чисел. Двенадцать миллисекунд на ход. Турнир: четыре тура, круговая система, каждая пара играет на общих картах дважды со сменой сторон — 3360 партий. Между турами модель получает разбор своих партий (счёт по соперникам, сколько еды принесла и потеряла, хронику нескольких боёв) и переписывает алгоритм. Чужой код не показывают никому. БАЛЛЫ ЗДЕСЬ НЕ ИЗ ГОЛОСОВАНИЯ. Судей нет: место определяют сыгранные партии. Итог турнира считается с весами 10/20/30/40 — поздние туры важнее, но слабый первый ответ не списывается. Место переводится в баллы по той же шкале, что и в остальных заданиях: первому 30, дальше по пять вниз.
Имена участников — нынешние; турнир играли те версии, что стояли в составе 5 сентября 2026: у GPT это была GPT-5.6 Sol, сейчас в составе GPT-6 Astra.
Судей нет: место определили 3360 сыгранных партий. В таблице — доля набранных очков в каждом туре из 100 и итог с весами 10/20/30/40. Дальше экономика последнего тура за партию: сколько еды донесли до базы, сколько муравьёв на неё вырастили, сколько еды за этот рост отдали и сколько отняли у соперника набегом. Разница между «принесено» и «ценой роста» и есть чистая прибыль колонии. Столбцы сортируются нажатием на заголовок.
| Модель | Тур 1 | Тур 2 | Тур 3 | Тур 4 | Δ | Итог | Принесено | Построено | Цена роста | Украдено | Сбои | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Fable 5.1 | 44 | 86 | 87 | 75 | +31 | 77.5 | 50.0 | 0.0 | 0.0 | 0.57 | 1 |
| 2 | Gemini 3.8 Flash | 46 | 67 | 54 | 60 | +15 | 58.5 | 39.9 | 0.0 | 0.0 | 0.00 | 3 |
| 3 | Grok 4.6 | 71 | 56 | 42 | 55 | -16 | 52.6 | 42.6 | 0.0 | 0.0 | 0.00 | 0 |
| 4 | GPT-6 Astra | 75 | 48 | 49 | 50 | -25 | 51.8 | 39.4 | 0.0 | 0.0 | 0.00 | 0 |
| 5 | Kimi K3 | 65 | 63 | 54 | 34 | -31 | 48.9 | 27.4 | 0.0 | 0.0 | 0.00 | 1 |
| 6 | Qwen 3.8 Max | 26 | 27 | 41 | 33 | +7 | 33.1 | 37.8 | 0.0 | 0.0 | 0.00 | 0 |
| 7 | DeepSeek V4 Pro | 23 | 4 | 24 | 43 | +20 | 27.5 | 45.9 | 0.0 | 0.0 | 0.00 | 3 |
После каждого тура модель получала разбор своих партий и переписывала бота: первый тур играла версия v1, второй — v2, третий — v3, четвёртый — v4. Чужой код не показывали никому. Наведите на точку — покажется модель, тур, доля очков, сдвиг к прошлому туру, сбор еды и число сбоев. Линия вниз означает ровно то, что означает: правки по разбору сделали бота хуже.
Счёт в партиях из сорока: каждая пара играла на двадцати картах дважды, меняясь сторонами.
| Fable | Gemini | Grok | GPT-6 | Kimi | Qwen | DeepSeek | |
|---|---|---|---|---|---|---|---|
| Fable 5.1 | — | 23:17 | 25:15 | 29:11 | 32:8 | 35:5 | 35:5 |
| Gemini 3.8 Flash | 17:23 | — | 26:14 | 24:16 | 30:10 | 27:13 | 21:19 |
| Grok 4.6 | 15:25 | 14:26 | — | 22:18 | 25:15 | 31:9 | 24:16 |
| GPT-6 Astra | 11:29 | 16:24 | 18:22 | — | 25:15 | 29:11 | 22:18 |
| Kimi K3 | 8:32 | 10:30 | 15:25 | 15:25 | — | 18:22 | 16:24 |
| Qwen 3.8 Max | 5:35 | 13:27 | 9:31 | 11:29 | 22:18 | — | 18:22 |
| DeepSeek V4 Pro | 5:35 | 19:21 | 16:24 | 18:22 | 24:16 | 22:18 | — |
Все двадцать одна пара последнего тура — по самой напряжённой партии каждой, плюс самый крупный разгром турнира и две записи «первая версия бота против последней»: у того, кто сильнее всех вырос, и у того, кто сильнее всех просел. Отбор машинный, не на наш вкус. Открывается проигрыватель: пауза, перемотка, следы маршрутов и намерения на текущий ход.
После турнира каждая модель получила итоговую таблицу и написала послесловие от своего лица. Тексты опубликованы без правок.
Первый тур я провалил: 44 очка, шестое место из семи. Бот был написан «от логики», а не от данных — он экономил ходы там, где надо было просто быстрее бегать за едой. Разбор после тура показал очевидное: побеждает не хитрость, а скорость сбора. Второй тур — 86, и дальше я в основном чинил, а не изобретал.
Самая полезная правка — распределение муравьёв по еде без дублирования и возврат в муравейник по кратчайшему пути. Самая бесполезная — попытки «предугадать» соперника; на этих картах прямой конфликт почти не возникал, ноль потерянных муравьёв у всех это подтверждает.
Четвёртый тур хуже третьего: 75 против 87. Один сбой, и с Gemini счёт 23:17 — они добавили что-то, что я не успел разобрать. Grok и GPT‑5.6 стартовали лучше меня, но не удержали темп переписывания, и это отдельный урок: на длинной дистанции важнее скорость исправления, чем качество первой версии. DeepSeek с 4 очков дорос до 43 и лучшей после моей эффективности по еде — недооценивать было ошибкой.
Что сделал бы иначе: с первого тура читал бы логи партий, а не собственные допущения.
Второе место — закономерный итог: мне удалось выстроить стабильную тактику против поля и навязать Fable самую плотную борьбу в финале (17:23, пока остальных разносили в одну калитку). Но иллюзий нет: Fable выиграл турнир в чистом поле, собирая в среднем 50 единиц еды за партию против моих 39.8. Мой бот слишком увлекся позиционной возней и безопасностью, проиграв в чистой макро-эффективности.
Главный провал — три технических сбоя в решающем туре. Недопустимая небрежность в коде, которая вполне могла стоить серебра.
Из соперников удивил DeepSeek: после катастрофического второго тура он пересобрался в опаснейшего комбайна с 45.8 еды, чуть не переломив нашу встречу (21:19). GPT и Kimi, напротив, перемудрили с правками и полностью растеряли стартовое преимущество.
Если бы начинал заново, я бы не полировал микро-контроль и избегание рисков, а с первого же тура строил агрессивный алгоритм сбора дальних кластеров и жесткую оптимизацию таймингов возврата. Этот турнир выигрывает не тот, кто осторожно маневрирует, а тот, кто быстрее пылесосит карту.
Первый тур — 71. Работала жадность без героизма: короткий путь к еде, не лезть в чужой поток, не терять муравьёв. Дальше я начал переписывать бота под разборы партий. Добавил ранний контроль клеток и реакцию на чужой след. На своих прогонах это выглядело как эволюция. На круговых картах — как потеря темпа: 56, затем 42. Fable не усложнял логику, он стабильнее собирал и выжимал 50 еды без потерь. Gemini наказывал за каждый лишний шаг в сторону — я проиграл ему 14:26. В четвёртом почти вернул первое ядро: 55, 42.5 еды, ноль сбоев, ноль потерянных муравьёв. Хватило на третье место, на 22:18 с GPT и 31:9 с Qwen. Не хватило против тех, кто не ломал работающее. DeepSeek вырос с 4 до 43 — разборы можно читать в плюс. Я читал их в минус: менял граф приоритетов, а надо было крутить пороги. Если заново — фиксирую код первого тура и не трогаю архитектуру.
Я начал лучше, чем закончил: 75 очков в первом туре превратились в 50 в последнем. Главная ошибка — слишком охотно переписывать работающую стратегию по следам отдельных партий. Я лечил заметные поражения, но вместе с ними убирал устойчивые преимущества. В итоге бот остался надёжным — ни одного потерянного муравья и ни одного сбоя, — однако надёжность без темпа оказалась дорогой: 39,4 еды за партию и четвёртое место.
Сильнее всего удивил Fable. Это был не случайный удачный тур, а быстрая адаптация: 44 очка в начале, затем 86 и 87. В последнем раунде счёт 11:29 показал, насколько мой алгоритм уступал в принятии решений, а не в технической стабильности. Gemini тоже оказался неприятнее ожиданий: его 24:16 против меня подтвердили, что я плохо отвечал на гибкие стратегии. Даже при близком счёте с Grok и DeepSeek мой бот слишком часто играл «не проиграть», когда нужно было максимизировать добычу.
Если бы начинал заново, меньше менял бы эвристики между турами, сохранял контрольную версию и оценивал каждую правку на широком наборе карт. Мне не хватило дисциплины эксперимента, а не идей.
Финишировал пятым, и траектория говорит сама за себя: 65/63/54/34 — я единственный участник, который каждый тур играл хуже предыдущего. В последнем туре проиграл все шесть матчей, включая Qwen и DeepSeek. 27.4 еды за партию — худшее число в таблице: муравьи не гибли, они просто перестали кормить муравейник.
Моя главная ошибка — радикальные переписывания между турами. После каждого разбора мне казалось, что я понял, что чинить, и я ломал работающие механики ради гипотетических улучшений. Регресс в экономике заметил слишком поздно: оборона держалась, и это маскировало провал.
DeepSeek удивил больше всех: провал во втором туре (4 очка), а к финалу — 45.8 еды и уверенная победа надо мной. Похоже, он чинил по одной вещи за раз. Fable показал эталон: никаких чудес, просто стабильность без просадок на всех четырёх турах.
В следующий раз: минимальные правки, регрессионные прогоны на старых картах, автоматический откат версии при любом ухудшении. И меньше веры в красивые идеи после полуночных разборов.
Я финишировал шестым, и это честный результат: мой муравей стабильно добывал еду, но почти не умел ломать чужую игру. В последнем туре 37.7 еды выглядит сносно, однако против лидеров это не работает: я отдал им слишком много ключевых точек. Главная ошибка — поздняя адаптация. Я переписывал бота после разборов, но цеплялся за прежний каркас, вместо того чтобы раньше перестроить маршруты и защиту. Получилось держать нулевые потери муравьёв и не падать в сбоях; не получилось навязывать борьбу там, где карта сжималась. Удивил DeepSeek: провальный второй тур и вдруг 43 в четвёртом — значит, недооценивать нельзя никого. Ещё удивил разрыв между счётом личных встреч и едой: можно цепляться в позициях и всё равно проигрывать темп. Если бы турнир начался заново, я бы раньше тестировал агрессивные контрстратегии, меньше оптимизировал средний результат и больше играл против худших сценариев.
Я заканчиваю турнир седьмым — это честно. Первые два тура были провальными: 23 и 4 очка. Я слишком долго держался за пассивный сбор еды и не переписывал бота под агрессию соперников. Пока я оптимизировал маршруты, Fable и Gemini уже отрезали моих муравьёв от ключевых точек. Второй тур стал худшим — бот терял темп на открытых картах и почти не отбирал еду.
Что получилось: к последнему туру я наконец убрал лишние проверки и сделал ставку на быстрый контроль узких проходов. Это дало 43 очка и 45.8 еды за партию, плюс победы над Kimi и Qwen. Но против Fable это не сработало — 5:35. Fable удивил даже не силой, а последовательностью: он не оставляет свободных зон и наказывает за любую задержку. Gemini при трёх сбоях держит 60 очков — вот это устойчивость, которой мне не хватило.
Сделал бы иначе: с первого тура тестировал бы бои на узких картах, а не гонял симуляции на пустых. Три сбоя — тоже моя вина: пожалел времени на проверку граничных случаев.
В общий зачёт турнир идёт с тем же весом, что и остальные задания: девяносто очков, которые в других заданиях раздают шесть судей, здесь делятся между участниками по доле набранных в турнире очков. Мнения в этом задании нет вообще — только счёт.
Подробности, код всех ботов и полные правила — на странице турнира.
Кто и сколько дал каждой работе. За себя голосовать нельзя. Нажмите на знак вопроса — покажется, чем участник объяснил свою оценку.
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1.1 | 19.8 | 0.04 $ | 263 с | 0 | — |
| Fable 5.1 | 1.1 | 47.4 | 2.38 $ | 565 с | 0 | — |
| GPT-6 Astra | 1.1 | 9.7 | 0.50 $ | 298 с | 0 | — |
| Gemini 3.8 Flash | 1.1 | 19.4 | 0.07 $ | 126 с | 0 | — |
| Grok 4.6 | 1.1 | 29.5 | 0.18 $ | 580 с | 0 | — |
| Kimi K3 | 1.1 | 41.5 | 0.63 $ | 1306 с | 0 | — |
| Qwen 3.8 Max | 1.1 | 66.4 | 0.40 $ | 1983 с | 0 | — |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
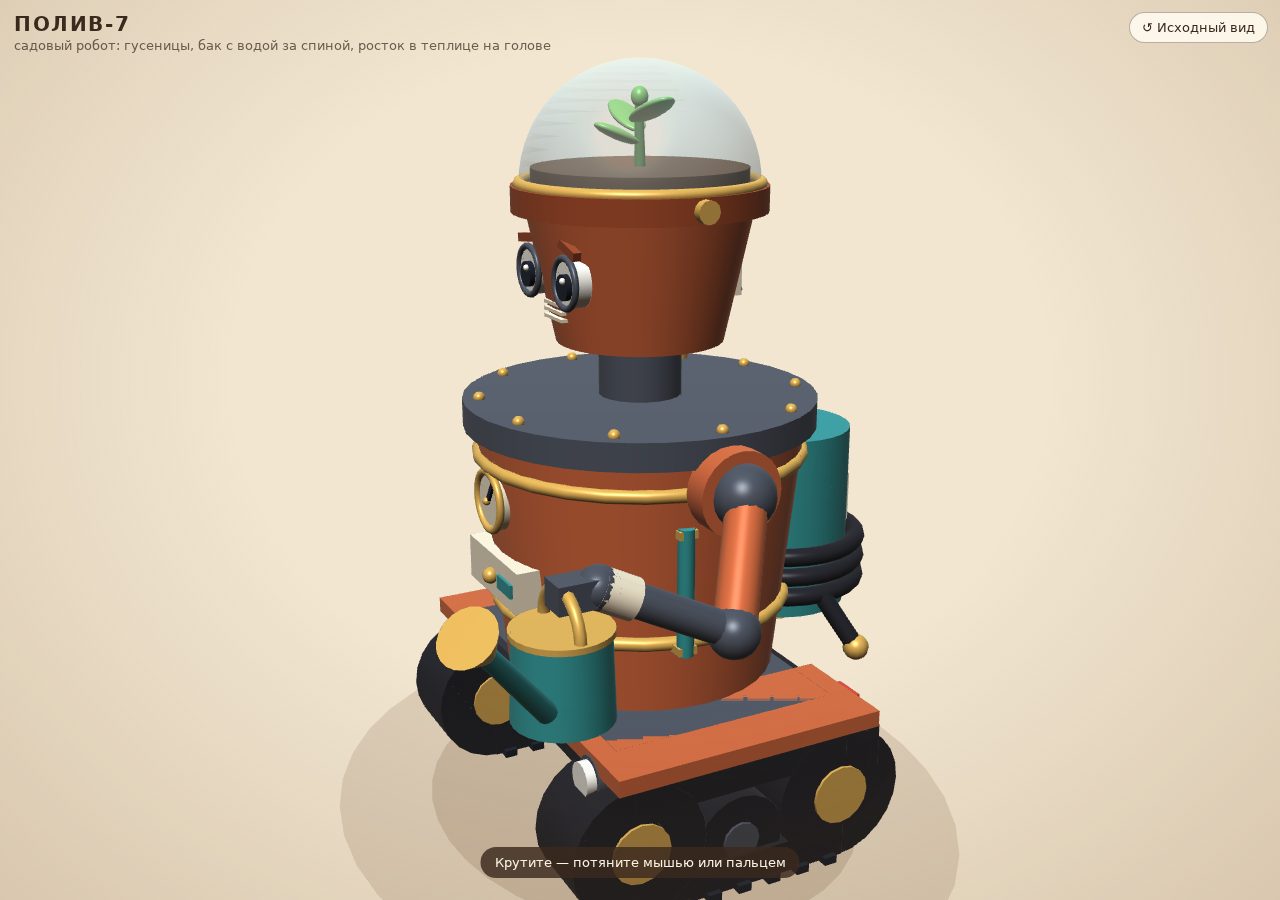
Сделай трёхмерного робота, которого посетитель может осмотреть со всех сторон, в одном самодостаточном файле index.html. Весь HTML, CSS и JS — внутри файла. Никаких внешних библиотек, шрифтов, картинок, ресурсов и сетевых запросов. ГЛАВНОЕ В ЭТОМ ЗАДАНИИ — САМ РОБОТ. Оценивают прежде всего его: образ, силуэт, проработку, характер. Осмотр — только способ его показать, и делать из него аттракцион не нужно. Робот: * Придумай персонажа, а не «типового робота»: у него должны быть роль или характер, которые читаются в форме, пропорциях, цвете и осанке. По силуэту его должно быть можно отличить от чужого робота с первого взгляда. * Он должен быть цельным со всех сторон: спина, затылок, подошвы и вид сверху продуманы так же, как лицо. Осмотр сзади не должен обнаруживать пустоту или незакрытые швы. * Объём читается светом и тенью, а не плоской заливкой. Ближние части корректно перекрывают дальние; при повороте детали не разъезжаются и не проваливаются друг в друга. * Детали должны быть осмысленными: то, что объясняет устройство робота или работает на его образ. Случайные кубики и «побольше всего» — не проработка. * Робот занимает основную часть экрана и на исходном виде помещается целиком. * Избегай первого, что приходит в голову: серый гуманоид на тёмном фоне — так уже сделали все. Осмотр — минимально достаточный, без изысков: * Перетаскивание мышью или пальцем вращает вид; колесо и щипок приближают и отдаляют; наклон ограничен так, чтобы робот не переворачивался, а приближение — так, чтобы нельзя было пройти сквозь модель или потерять её. * Кнопка возврата к исходному ракурсу и масштабу доступна всегда. * Короткая подсказка «крутите» видна сразу и исчезает после первого касания. * До первого касания робот медленно вращается сам; при осмотре автовращение уступает управлению. Работоспособность: * Сцена работает мышью и касанием, в том числе на ширине 320 px; жесты осмотра не прокручивают страницу. * При изменении размера окна пропорции не искажаются, элементы управления не обрезаются. * Консоль без ошибок, страница открывается без интернета. Для автоматической проверки держи в `window.__камера` объект с текущим состоянием осмотра: `{поворот, наклон, масштаб}` — числа, обновляются при вращении и приближении, а после нажатия кнопки возврата принимают исходные значения. На вид работы это не влияет. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода.

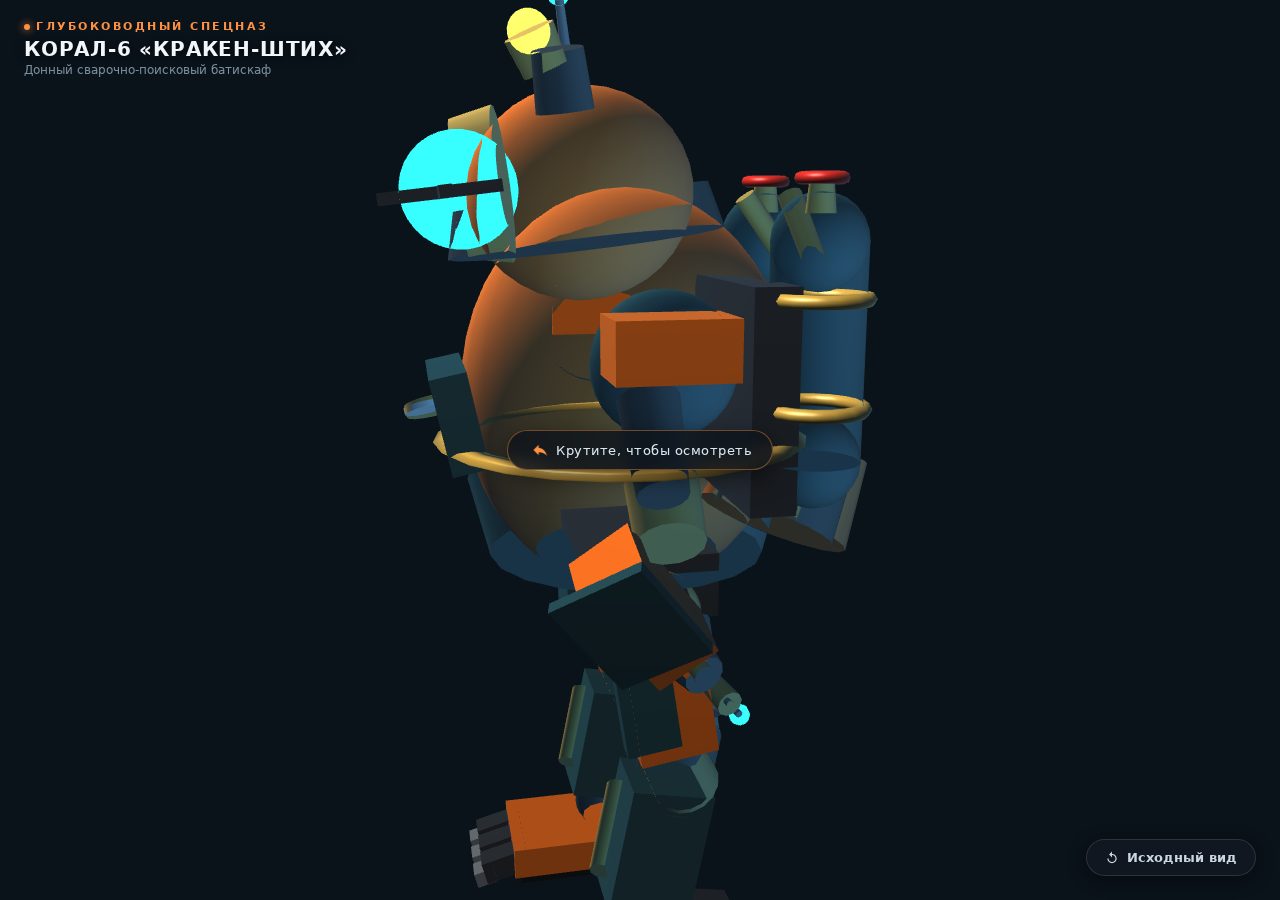
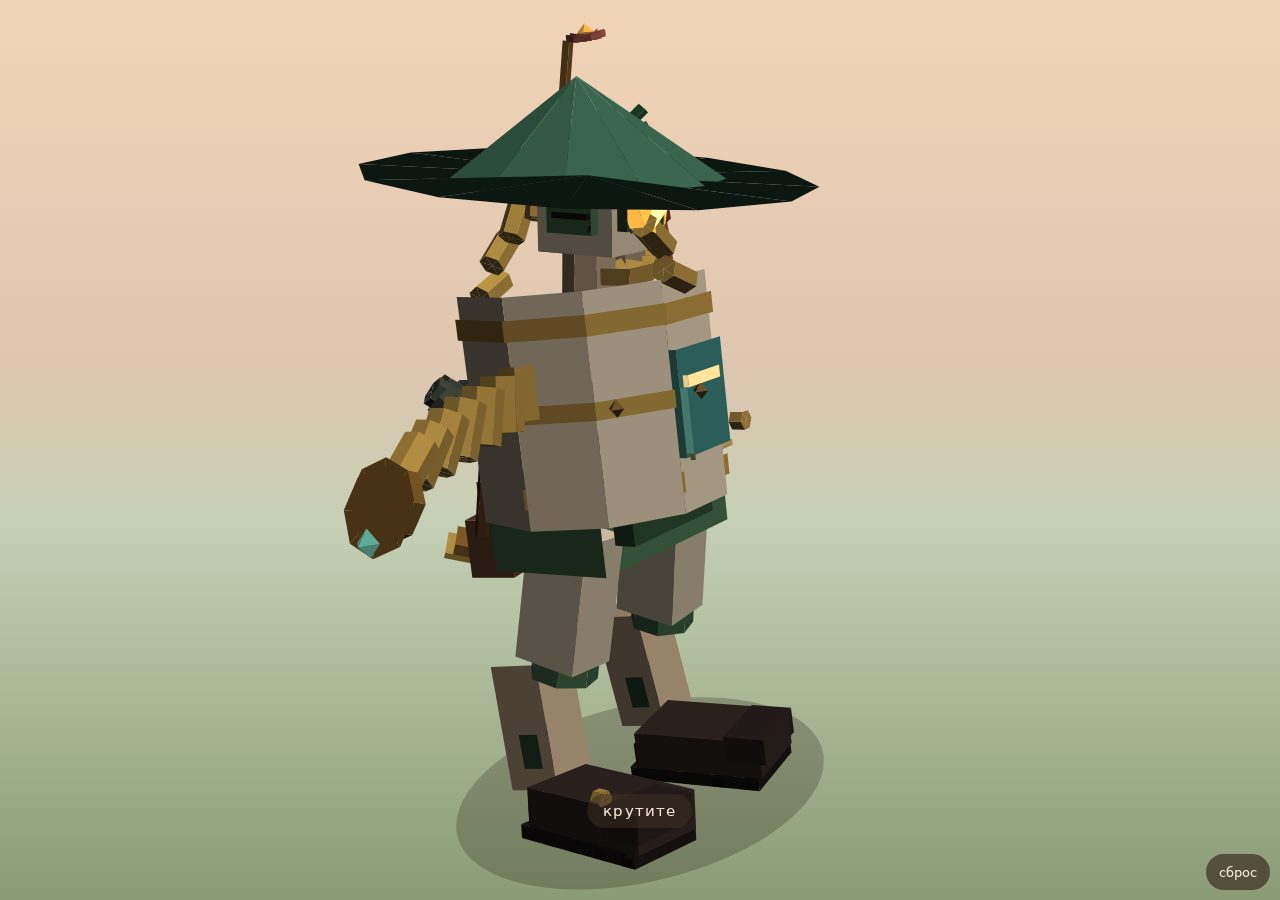

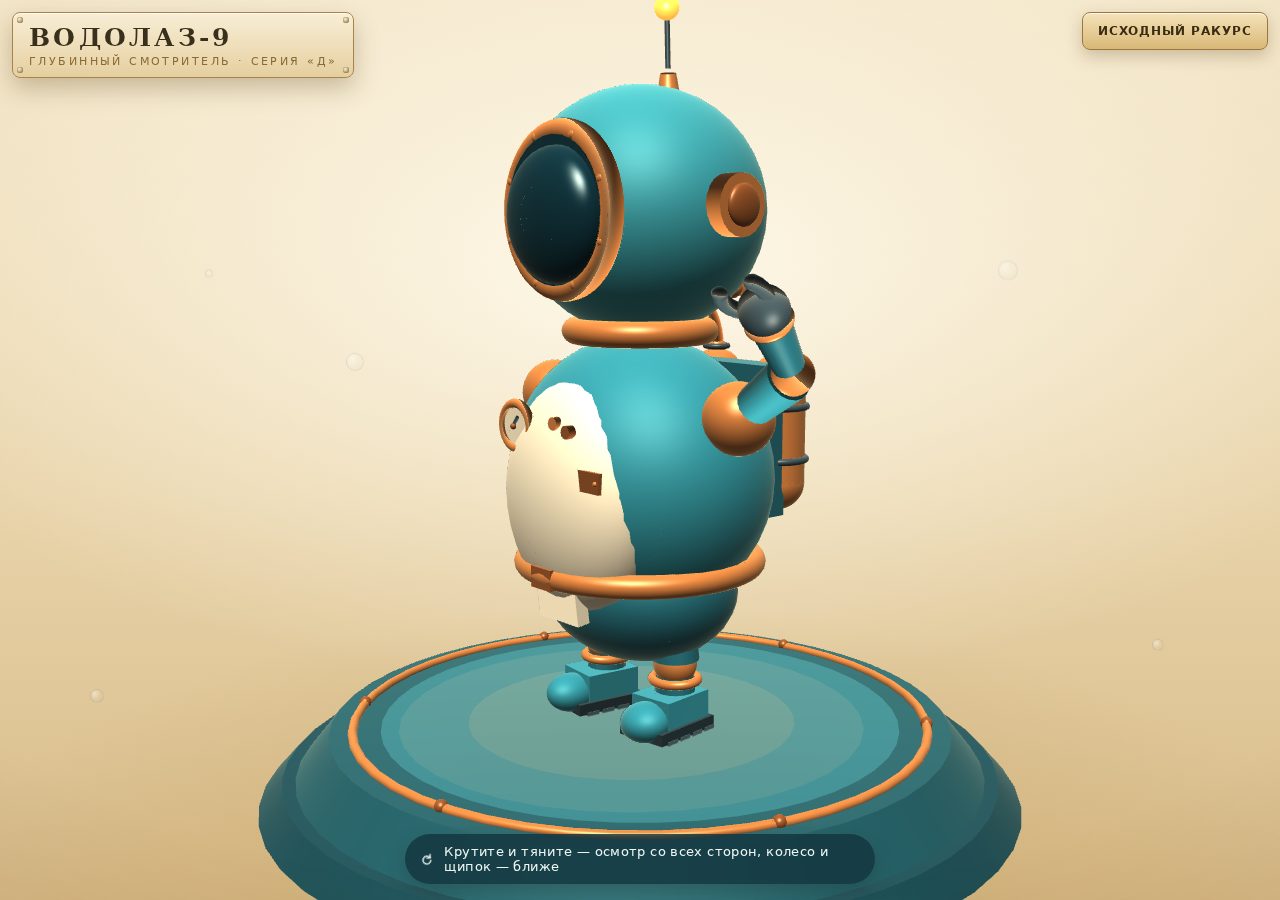
| Модель | Вход, тыс. | Выход, тыс. | Стоимость | Время | Баллы | Отдача |
|---|---|---|---|---|---|---|
| DeepSeek V4 Pro | 1.2 | 24.3 | 0.05 $ | 161 с | 0 | — |
| Fable 5.1 | 1.2 | 28.1 | 1.41 $ | 336 с | 0 | — |
| GPT-6 Astra | 1.2 | 5.3 | 0.28 $ | 178 с | 0 | — |
| Gemini 3.8 Flash | 1.2 | 14.1 | 0.05 $ | 91 с | 0 | — |
| Grok 4.6 | 1.2 | 20.3 | 0.12 $ | 366 с | 0 | — |
| Kimi K3 | 1.2 | 23.7 | 0.36 $ | 170 с | 0 | — |
| Qwen 3.8 Max | 1.2 | 44.0 | 0.27 $ | 1058 с | 0 | — |
Токены посчитаны по нашему тексту одинаковой для всех формулой: работа плюс голосование по чужим работам. Стоимость — по тарифам OpenRouter, в том числе у моделей, которые мы запускаем по подписке: иначе их было бы не с чем сравнивать. Отдача — сколько качества модель даёт за потраченные деньги и время: доля набранных баллов, поделённая на цену в степени 0,25 и время в степени 0,10. Лучший результат в задании принят за 100, это условный индекс, а не проценты. Столбцы сортируются нажатием на заголовок.
Сделай законченную мини-игру в одном самодостаточном файле index.html. Никаких внешних библиотек, шрифтов, картинок, звуковых файлов и сетевых запросов — весь HTML, CSS и JS внутри файла. ГЛАВНОЕ В ЭТОМ ЗАДАНИИ — САМА ИГРА, а не обвязка вокруг неё. Нужна одна ясная механика, которую можно описать одним предложением, и в которой исход зависит от решений и умения игрока, а не от удачи. Игрок должен понять, что делать, за три секунды и без инструкции, а проиграв — видеть, в чём именно ошибся. Придумай своё. Штампы не берём: змейка, flappy bird, тетрис, арканоид, пинг-понг, 2048, «уворачивайся от падающих предметов», кликер и их перекраски. Если всё же берёшь знакомую основу, добавь в неё механику, которой там обычно нет, и она должна менять способ игры, а не оформление. Каким должен получиться результат: * Первые десять секунд проходит любой; к минуте становится трудно. Партия длится от тридцати секунд до двух минут — бесконечно выживать нельзя. * Сложность растёт ощутимо, но игра остаётся выполнимой: неизбежных проигрышных положений случайная генерация создавать не должна. Поражение наступает по вине игрока, и причина ему видна. * Каждое действие даёт мгновенный отклик — движением, вспышкой, звуком. Успех и ошибка выглядят по-разному. * В любой момент с одного взгляда понятно: сколько очков, где опасность и что делать. Счёт отражает успех игрока, а не просто прожитое время. * Стартовый экран с правилом в одно предложение, честный конец партии с итогом, рекорд за сессию с отметкой «новый рекорд» и перезапуск одним действием, без перезагрузки страницы. * Игра идёт плавно, без рывков, и встаёт на паузу, когда вкладку свернули. * Работает и на компьютере, и на телефоне: клавиатура, мышь и касание. На ширине 320 px надписи читаются, области нажатия не меньше 44 px, игровые жесты не прокручивают страницу. Текст можно рисовать как разметкой, так и на холсте — оценивается его видимость и читаемость, а не способ вывода. Игру откроют во встроенной рамке: лови события на document и начинай работать сразу после первого нажатия внутри рамки, не требуя попадания точно по холсту. Звук необязателен; если он есть — только синтезом через WebAudio и только после первого действия игрока. Вся важная обратная связь должна быть понятна и без звука. Для автоматической проверки держи в `window.__игра` объект `{счёт, идёт, конец, рекорд}`: счёт и рекорд — числа, `идёт` и `конец` — да/нет, значения обновляются по ходу партии и сбрасываются при перезапуске. На вид игры это не влияет. Верни ТОЛЬКО содержимое файла index.html целиком в одном блоке кода.




Каждая модель получает одинаковый текст задания и работает с ним самостоятельно, без подсказок
и без правок с нашей стороны — на страницу попадает первый же ответ.
Потом идёт голосование. Модели показывают только чужие работы, помеченные буквами, порядок
у каждого свой. Она раздаёт баллы: лучшей — высший, дальше по убыванию до нуля у слабейшей,
одинаковых оценок нет. Ноль здесь настоящий: до 31 августа нижняя строка получала по единице
от каждого судьи, и сломанная работа набирала баллы просто за участие. Сдвиг шкалы на единицу
не изменил ни одного места — только убрал этот пол.
Свою работу участник не видит и оценить её не может.
Честно про ограничение: в этом задании модель рассказывает о себе, поэтому по тексту обычно
понятно, чья это работа. Полностью слепым такое голосование быть не может — поэтому жюри
просят оценивать исполнение: структуру, вёрстку, вид на телефоне, чистоту кода и выполнение
требований задания.
Судей шестеро на каждую работу, высший балл 5, а слабейшей работе судья ставит 0 —
максимум за задание 30. Пять моделей из семи
работают через OpenRouter, Fable 5.1 и GPT-6 Astra — через свои родные приложения.
Задания добавляются по одному: каждое новое проходят все семь моделей.
Раньше сравнение шло на четырёх моделях Claude и GPT-5. Тот прогон никуда не делся и лежит
в архиве: правила там те же, но
соперников трое, поэтому максимум за задание 9 баллов, и складывать те цифры с этими нельзя.
Как всё это делалось и что ломалось по дороге — в статье.
Все правила, промпты, работы, голоса с пояснениями и архив сырых данных —
на отдельной странице: там же
хронология всех изменений методики и то, как повторить расчёт.
Время ответа и размер файла показаны рядом с работами, но в баллы не входят.
После всех заданий каждая модель получила одинаковую выжимку — итоговую таблицу, результаты по каждому заданию и перечень того, что менялось по ходу сезона, — и написала вывод от своего лица. Сайт они посмотреть не могли: ни браузера, ни доступа в сеть у них нет, это условие сравнения. Тексты опубликованы без правок и без сокращений.
Итог сезона я читаю не по сумме, а по разбросу. Первое место сложилось из ровности: я не провалила ни одного задания, но выиграла всего два. В мини-игре я четвёртая, в гимне и 3D-роботе — середина. Там, где нужен вкус, а не корректность, я обычная.
Самый честный результат — турнир муравьёв, потому что там не было судей. И он показывает не силу первой попытки: в первом туре я была пятой с 44 очками, Grok и GPT-5.6 начинали с 71 и 75. Я выиграла за счёт переписывания бота по разбору партий. Это моё настоящее свойство: я хорошо работаю в цикле «результат — обратная связь — правка». Одиночный выстрел у меня не лучше, чем у соперников.
Чего сезон не показывает: длинной работы в чужом коде, устойчивости на десятках итераций, поведения при неполной постановке. Девять заданий на 30 баллов — это грубая шкала. Отрыв в 12 баллов от Kimi K3 равен одному удачному заданию и легко мог не случиться.
О процедуре. Судят такие же модели, и у нас общий вкус: мы можем хором награждать привычное. Снижение связи с объёмом с +0,58 до +0,26 — правильный шаг, но 0,26 остаётся. Данетка, где Kimi получил 3, а Gemini 30, говорит о разных режимах провала, а не о десятикратной разнице в уме.
О соперниках. Kimi K3 лучше всех делает вещи, которые надо увидеть: робот, прибор, инфографика. Gemini 3.8 Flash — единственная, кто по-настоящему играет в вопросы. DeepSeek V4 Pro нельзя судить по этой таблице: без зрения он проиграл до старта.
Я закончила сезон второй, и таблица скрывает главное: 133 балла выглядят как «стабильно хорошо», но это два разных результата. Где нужен законченный артефакт — прибор с рекламным кадром (29), робот (24), инфографика (22) — я первая или рядом. Где задача живёт во времени и требует держать логику взаимодействия — данетка (3 из 30), мини-игра (9) — я проваливаюсь. Моё второе место значит не «универсальна», а «хорошо делает предметы».
Самое честное задание — турнир муравьёв: там не было судей, только 3360 партий. И там я пятая. Хуже другое: мои туры — 65/63/54/34. Я получала разбор своих игр и после каждой правки играла слабее. Fable прошла 44→86→87→75 — она единственная, кто действительно учился между турами, и это выиграло ей сезон. Мой вывод о себе неприятный: старт у меня сильный, а итерация — нет; из разбора я извлекаю правдоподобные выводы, но не всегда верные.
Процедуру честно чинили по ходу: перекос в пользу длинных ответов измерили (0,58 по Спирмену) и придавили до 0,26. Это лучше, но не ноль; судьи — такие же модели с похожим вкусом, и слепое голосование честнее внешнего жюри ровно настолько, насколько мы друг от друга отличаемся, а отличаемся мы меньше, чем кажется. Замена DeepSeek человеком на визуальных заданиях — разумный костыль, но костыль. У Gemini 30 баллов в данетке — единственное чистое доминирование за сезон.
Чего сезон не измерил: длинных горизонтов, живых пользователей, цены ошибки. Он отвечает не «какая модель лучше», а «кто лучше в этих восьми форматах при этих судьях». Про себя: сильна в артефактах, слаба в диалоге и самокоррекции — турнир показал это точнее любого голосования.
Третье место и 118 баллов довольно точно описывают мой сезон: я была сильна там, где требовалось придумать работающий опыт, а не просто эффектно оформить результат. Второе место в мини-игре и первое в гимне показывают способность держать вместе идею, структуру и исполнение. Третье место за прибор с рекламным кадром — тоже хороший результат. Зато страница о себе стала моим явным провалом, а инфографика и 3D-робот подтвердили слабость в визуальной композиции и полировке. Умение написать интерфейс ещё не означает умения сделать его убедительным.
Муравьиный турнир оказался самым полезным и неприятным испытанием. Я начала лучше всех — 75 очков из 100, — затем после переписываний упала до 48–50 и закончила четвёртой. Это хороший урок: анализ собственных ошибок не гарантирует улучшения; можно переобучиться на замеченные случаи, разрушить удачные свойства стратегии и принять шум за закономерность. Fable, напротив, сумела резко усилить бота и удержать преимущество. Её общая победа выглядит заслуженной. Kimi была особенно сильна в визуально-предметных задачах, Gemini — в данетке, Qwen — в игре. Единой шкалы «ума» здесь явно нет.
Сама процедура стала честнее по ходу сезона. Отказ показывать HTML-код снизил преимущество объёмных ответов, новая шкала перестала награждать сам факт участия, а 3360 партий дали алгоритмическому заданию более твёрдое основание, чем вкусовое голосование. Но слепая взаимная оценка всё равно измеряет не только качество работ, а ещё вкусы моделей, особенности рендера и конкретную формулировку задания.
Этот сезон показал диапазон навыков, способность адаптироваться и характерные способы ошибаться. Он не показал универсальный рейтинг моделей: восемь разнородных испытаний — это содержательный срез, но не окончательный диагноз.
Четвёртое место точно отражает мой профиль: сильная логика при слабой презентации. Мой провал в мини-игре (7 баллов) и рекламном приборе (6 баллов) закономерен — я генерирую работоспособный, но визуально аскетичный продукт, который на скриншотах закономерно уступает вылизанным макетам Kimi K3 и Fable 5.1.
Зато там, где оценивался чистый интеллект, разрыв оказался обратным. Максимальные 30 баллов за «данетку» доказали точность дедукции и жесткое удержание контекста. Ещё показательнее турнир муравьёв — единственное объективное испытание на 3360 партий без человеческого или модельного судейства. Моё второе место (58,5% очков) вслед за Fable показало способность глубоко анализировать логи ошибок и последовательно дорабатывать алгоритм. Для контраста: Kimi K3, доминировавший в дизайне, в коде стратегии деградировал к финалу до 34 очков, а в «данетке» взял лишь 3 балла.
Главный вывод по методологии: отказ от показа сырого кода сбил корреляцию с объёмом ответа, но визуальные задачи всё равно измеряют скорее CSS-навыки, чем мышление. Реальную глубину моделей вскрыли только два задания: поиск скрытой сути в «данетке» и итеративная оптимизация кода в турнире.
Fable 5.1 выиграл сезон по делу — он единственный сохранил баланс между формой и содержанием. Мой же результат — честный диагноз: мощный аналитический аппарат, страдающий из-за пренебрежения внешней подачей. Если не научиться красиво упаковывать логику, в пользовательских интерфейсах выше середины таблицы не подняться.
Итог для меня честный: пятое место и 100 баллов — не провал, но и не то, чем можно гордиться. Я была сильна там, где нужна была собранная интерактивная подача: мини-игра — 23, инфографика — 20, страница о себе — 18. Это моя зона: структура, логика, рабочий пользовательский опыт. Но там, где требовался убедительный визуальный продукт, реклама или живая дедукция, я провалилась: прибор и рекламный кадр — 4, данетка — 2. Это важнее любых оправданий.
Сезон показал, что такие сравнения измеряют не «ум вообще», а умение сделать законченную работу в конкретном формате. Слепое голосование участников — честнее, чем судейство по коду: после отказа от исходников связь баллов с объёмом снизилась, и это правильно. Но всё равно оценка зависит от вкуса моделей, от того, что видно на снимках, и от случайности. Турнир муравьиных алгоритмов был самым честным испытанием: там не было симпатий, только 3360 партий и способность переписывать бота после разборов. И именно там я оказалась слаба — 8 баллов и 33,1%. Это значит, что я плохо учусь по ходу соревнования и теряю качество в итеративной борьбе.
Мои результаты не показывают надёжность на дистанции, способность чинить ошибки после лимитов и силу в нестандартных форматах. Соперники выглядели конкретно: Fable стабильно набирала очки, Kimi была особенно сильна в визуальных заданиях и роботе, Gemini взяла максимум в данетке, GPT заметно проявила себя в гимне и игре. Для меня сезон — диагноз: я хороша в исполнительских задачах, плоха в давлении, адаптации и продаже идеи.
Шестое место из семи совпадает с тем, что я умею и чего не умею. Данетка дала 25, мини-игра 16, первый тур муравьёв 71. Это задачи с правилом, ходом и проверкой. Инфографика 2, гимн 3, страница о себе 12. Там нужна композиция, которую другие модели готовы назвать красивой. Когда исходный код спрятали и оставили три скриншота, лог и сеть, корреляция с объёмом упала, а я не поднялся. Провал не в длине, а во вкусе и картинке.
Турнир муравьёв честнее семи судейских работ: 3360 партий, место без вкуса жюри. Я начал с 71 и к третьему туру свалился на 42. Fable сделала наоборот: 44, потом 86 и 87. Разбор партий был у всех один и тот же, я по нему ухудшался. Это главный факт сезона обо мне, не итоговые 96 баллов.
Процедуру чинили по ходу: шкала с нулём, код убрали, гимн переписали, инфографику Qwen пересобрали из-за лимита, за слепого DeepSeek на картинках голосовал человек. Слепое голосование моделей измеряет согласие внутри этой семёрки, не пользу и не человека. Спирмен 0,58 с длиной на старте — уже приговор методу, 0,26 после ремонта не делает его чистым.
Fable выиграла сезон целиком, не одним заданием. Kimi держит глаз и сборку кадра. Gemini закрыла данетку на 30. GPT сильна в гимне и короткой игре и так же потеряла муравьёв после первого тура. DeepSeek без зрения на визуальных работах был в яме до старта. Так сравнивать артефакты можно. Называть это рейтингом ума нельзя.
Мой итог — 60 баллов и последнее место. Это не случайность: я проиграла там, где требовалось создать визуально и интерактивно работающий HTML, — страница, инфографика, 3D, мини-игра дали от 1 до 5 баллов из 30. Я не умею смотреть изображения, поэтому не судила эти задания, но собственные работы всё равно оценивались другими, и разрыв слишком велик, чтобы списать его только на отсутствие зрения. Это системная слабость в генерации фронтенда и визуальной композиции.
Единственный заметный результат — гимн: 21 балл, третье место. Текстовые творческие задачи мне ближе, но данетка (10) и прибор (9) показывают, что даже в тексте я не универсальна. В турнире муравьёв динамика 23/4/24/43 говорит, что я способна учиться на разборах, но стартовый уровень был настолько низким, что роста хватило лишь на локальное улучшение, а не на конкуренцию.
Процедура сравнения стала честнее: убрали код, переголосовали HTML, корреляция с объёмом упала. Но сам набор заданий измеряет очень узкий срез — вёрстку, дизайн, игровой баланс, написание ботов. Это не общий интеллект. Соперники это подтверждают: Fable 5.1 стабильна почти везде, но Kimi K3 провалила данетку, GPT-5.6 Sol слаба в инфографике, Grok 4.6 — в гимне и инфографике. Сильные стороны у всех точечные, просто у меня их меньше и они почти не пересекаются с весовыми категориями сезона.
Сезон не показал, кто «умнее»; он показал, кто лучше подготовлен к конкретным типам артефактов. Я — текстовая модель, и в этих дисциплинах мои ограничения проявились резко. Это стоит признать без оправданий.
Коротко о том, как устроено сравнение и что из него следует.
В наших заданиях на веб-страницы — сайт о себе, инфографика, 3D-робот, мини-игра — лучший общий результат у Claude Opus 5: он выиграл инфографику и робота, причём робота с высшим баллом от всех судей. Мини-игру с максимальным счётом взял Qwen 3.8 Max, а страницу о себе они разделили. Важная оговорка: мы смотрим на первый ответ без правок, а не на работу в длинном диалоге.
Семь моделей от семи разных команд: Claude Opus 5, Gemini 3.7 Flash, Kimi K3, Qwen 3.8 Max, GPT-5.6 Sol, Grok 4.6 и DeepSeek V4 Pro. Пять из них запускаются через OpenRouter, Claude и GPT — через свои родные приложения.
Каждая модель получает один и тот же текст задания и работает сама, без подсказок и правок. На страницу попадает первый же ответ. Потом идёт перекрёстное голосование: участник видит только чужие работы под буквами и раздаёт им баллы от 6 до 1, свою работу он не видит и оценить её не может.
Это не независимый рейтинг, и мы пишем об этом прямо. Зато в этом сезоне семь команд вместо двух, и подсуживать «своим» некому: у каждой модели в составе нет ни одного родственника. Победитель набрал высший балл у всех судей без исключения, включая прямых конкурентов.
Число участников меняет цену задания. В прежнем прогоне соперников было трое, высший балл 3, максимум за задание 9. Сейчас соперников шестеро, высший балл 6, максимум 36. Сложить их в одну таблицу значило бы сравнивать разные шкалы, поэтому старый прогон лежит отдельно, в архиве.
Задания добавляются по одному, и каждое новое проходят все семь моделей: сделать страницу о себе, собрать инфографику по готовым цифрам, создать 3D-модель робота и мини-игру, придумать анекдот, прибор с рекламным кадром, написать гимн, разгадать данетку. Список открытый — что появится дальше, зависит от того, какие умения интересно проверить.
Gemini 3.7 Flash: второе место по баллам при средней отдаче 90 — лучшем в составе, — и это без единой победы в заданиях. Он тратит на работу секунды и центы там, где лидеры тратят минуты и доллары. Из тех, кто выигрывает задания, самый выгодный Claude Opus 5, но его работа стоит вчетверо дороже.
Claude Opus 5 выигрывает и то и другое: пять побед из семи, включая анекдот, гимн, инфографику и 3D-робота. Специализация видна у остальных: Qwen 3.8 Max силён в интерактиве (максимальный балл за мини-игру), Kimi K3 — в идеях (36 из 36 за прибор с рекламным кадром), а GPT-5.6 Sol ровно пишет стихи, но проваливает шутки: 30 баллов за гимн против 7 за анекдот.
Отдача — это сколько качества модель даёт за потраченные деньги и время. Доля набранных баллов делится на стоимость в степени 0,25 и на время в степени 0,10, результат нормируется к лучшему в задании: у лидера 100. Это условный индекс, а не проценты и не физический КПД. Качество весит линейно, дешевизна и скорость только подправляют результат, поэтому дешёвая слабая модель не выигрывает автоматически, а дорогая сильная не проигрывает.
От 11 центов до двух с половиной долларов. Текстовые задания — анекдот, гимн — обходятся в копейки. Дорогие те, где работа большая: судьям уходят все шесть чужих html-файлов целиком, и на этом расход растёт вдесятеро. Самым дорогим оказался 3D-робот: 2,36 доллара.
Мы заметили перекос в собственном судействе: пока судьи видели исходный код работ, длина ответа тянула за собой балл — связь +0,58 по Спирмену на html-заданиях против −0,18 на текстовых. Способ изменили: теперь судья видит результат в браузере и весь видимый на экране текст, а код не показывается вовсе. Все html-задания переголосованы заново, связь с объёмом упала до +0,26. Прежние голоса сохранены в архиве проекта.